 囫囵
人类辅导、智能辅导系统与其他辅导方式的相对有效性
The Relative Effectiveness of Human Tutoring, Intelligent Tutoring Systems, and Other Tutoring Systems|Kurt VanLehn|Educational Psychologist, 2011, 46(4): 197–221
作者:Kurt VanLehn(美国亚利桑那州立大学计算、信息学与决策系统工程系)。 通讯地址:Kurt VanLehn, Computing, Informatics and Decision Systems Engineering, Arizona State University, PO Box 878809, 699 South Mill Avenue, Tempe, AZ 85287-8809;电子邮箱:[email protected]。 出处:Educational Psychologist, 46(4), 197–221, 2011;版权所有:美国心理学会第 15 分会(Division 15, American Psychological Association);ISSN: 0046-1520(印刷版)/ 1532-6985(在线版);DOI: 10.1080/00461520.2011.611369。
摘要
本文是一篇综述,考察了那些比较人工辅导(human tutoring)、计算机辅导与无辅导(no tutoring)之有效性的实验。“无辅导”指教授相同内容但不提供辅导的教学。计算机辅导系统按用户界面交互的粒度分为基于答案的(answer-based)、基于步骤的(step-based)与基于子步骤的(substep-based)辅导系统。大多数智能辅导系统(Intelligent Tutoring System,ITS)具有基于步骤或基于子步骤的交互粒度,而大多数其他辅导系统(常称为 CAI、CBT 或 CAL 系统)采用基于答案的用户界面。人们普遍认为,辅导的粒度越细,有效性越高。具体而言,与无辅导相比,基于答案的辅导系统、智能辅导系统与成人人类辅导者的效应量(effect size)通常被认为分别是 d = 0.3、1.0 和 2.0。本综述并未证实这些看法。相反,它发现人工辅导的效应量要低得多:d = 0.79。而且,智能辅导系统的效应量为 0.76,因此它们几乎与人工辅导同样有效。
引言
自计算机诞生之初,研究者就一直致力于开发与人类辅导者同样有效的计算机辅导系统(S. G. Smith & Sherwood, 1976)。本综述就是一份进展报告。它比较了计算机辅导系统与人类辅导者对学习收益的影响。具体而言,本综述聚焦于那些在比较两种辅导方式的同时力图控制其他所有变量(如教学内容与教学时长)的实验。
接下来几段界定本文所综述的辅导的主要类型,首先从人工辅导谈起。随后给出关于各类辅导相对有效性的通行看法,接着列举对这些看法的八种常见解释。在这些理论要点的基础上,引言最后提出一个精确的假设,并在综述主体部分用元分析方法加以检验。
尽管“人工辅导”一词所涵盖的活动五花八门,本文所说的“人工辅导”特指由一名成人学科专家与一名学生同步开展工作。这排除了许多其他形式的人工辅导,例如同伴辅导(peer tutoring)、跨龄辅导(cross-age tutoring)、异步在线辅导(如电子邮件或论坛),以及由一名“辅导者”带一个小组学生的问题式学习。计算机辅导系统的开发者之所以把成人的、一对一的、面对面的辅导奉为黄金标准,主要原因或许在于一种广为流传的信念:这种辅导是一种极其有效的教学方式(如 Graesser, VanLehn, Rose, Jordan, & Harter, 2001)。持这种信念的并不只是计算机开发者。例如,家长有时会不惜付出巨大牺牲,为孩子聘请私人辅导教师。
即便在这个受限的定义之内,仍可作进一步区分。例如,同步人工辅导包括面对面的、以语音为媒介的和以文本为媒介的即时交流。人工辅导既可作为学生课堂教学的补充,也可作为替代(如在家上学期间)。辅导可以教授新内容,也可以纯粹是补救性的。由于其中一些区分很难精确界定,本综述允许“人工辅导”涵盖上述所有子类,唯一的前提是这些变量在评估中得到控制。例如,如果人工辅导纯属补救性质,那么与之比较的计算机辅导也应当纯属补救性质。简言之,本综述所考察的人工辅导包括由成人学科专家实施的一切形式的一对一同步辅导。
人工辅导被视为一个单一的整体类型;与此不同,计算机辅导传统上区分出两种技术类型。第一类的特征是就学生的答案给出即时反馈和提示。例如,在要求解一个一元二次方程时,学生先在草稿纸上算出答案,输入该数值,随后或受到称赞,或得到一个提示并被要求再试。这类辅导系统有许多传统名称,包括计算机辅助教学(Computer Aided-Instruction,CAI)、计算机本位教学(Computer-Based Instruction)、计算机辅助学习(Computer-Aided Learning)和计算机本位培训(Computer-Based Training)。
第二类计算机辅导的特征是为学生提供电子表单、自然语言对话、模拟仪表板或其他用户界面,让他们能够输入解题所需的步骤。例如,在要求解一个一元二次方程时,学生可能先从菜单中选择一种方法(如配方法),于是屏幕上出现与该方法对应的表单,其中留有标注为“一次项系数”“一次项系数一半的平方”等的空白栏。或者,学生可能得到一块数字画布用以书写中间计算,或与一个智能体对话,后者说:“我们来解这个方程。该用什么方法?”关键只在于:通常写在纸上或在真实世界中实施的中间步骤,改为在辅导系统能够感知并解释它们的地方完成。辅导系统就每一步给出反馈和提示。有些辅导系统在每一步输入时立即给出反馈和提示;另一些则等学生提交解答之后,或标出哪些步骤正确、哪些错误,或进行一次“讲评”,与学生逐一讨论各个步骤。这类辅导系统通常被称为智能辅导系统(Intelligent Tutoring Systems,ITS)。
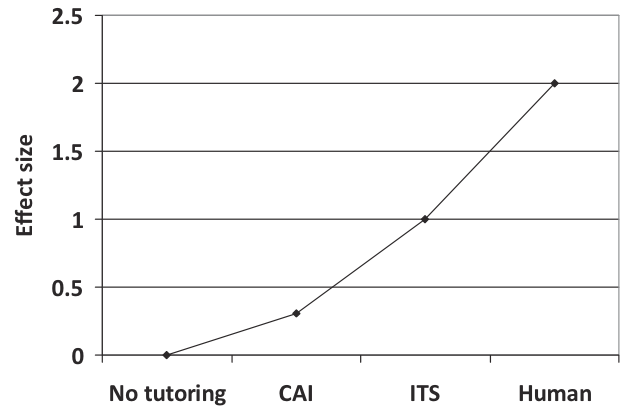
计算机辅导研究者中一个普遍的看法是:相对于没有辅导的课堂教学,人工辅导的效应量为 d = 2.0(Bloom, 1984; Corbett, 2001; Evens & Michael, 2006; Graesser et al., 2001; VanLehn et al., 2007; Woolf, 2009)。相比之下,CAI 往往产生 d = 0.31 的效应量(C. Kulik & Kulik, 1991)。虽然目前尚无针对 ITS 的元分析,但一项被广泛引用的、对若干早期 ITS 的综述反复发现平均效应量为 d = 1.0(Anderson, Corbett, Koedinger, & Pelletier, 1995)。图 1 将这些看法呈现为效应量随辅导类型变化的图形。近来已有很多针对 ITS 的评估研究,因此有必要检验图 1 的这些论断。
图 1|关于各类型辅导效应量的通行看法。 注:CAI = 计算机辅助教学;ITS = 智能辅导系统。(纵轴为效应量,刻度 0–2.5;横轴依次为:无辅导、CAI、ITS、人类。)
本文给出的综述扩展了此前关于人工辅导与计算机辅导的若干元分析(Christmann & Badgett, 1997; Cohen, Kulik, & Kulik, 1982; Fletcher-Flinn & Gravatt, 1995; Fletcher, 2003; J. Kulik, Kulik, & Bangert-Drowns, 1985; J. Kulik, Kulik, & Cohen, 1980; J. A. Kulik, Bangert, & Williams, 1983; G. W. Ritter, Barnett, Denny, & Albin, 2009; Scruggs & Richter, 1985; Wasik, 1998)。上述所有元分析都只比较了两种教学:有辅导与无辅导。有些元分析聚焦于计算机教学,有些聚焦于人类教学,但大多数元分析只关注一种辅导类型。与此不同,本综述比较五种教学:人工辅导、三种计算机辅导,以及无辅导。“无辅导”方法覆盖与辅导相同的教学内容,通常是阅读与解题(无反馈)的组合。无辅导及其他辅导类型的具体例子将在后文“三个示例研究”一节给出。
理论:人类辅导为何如此有效?
人们普遍相信,当教授相同内容时,人类辅导者比计算机辅导者更有效。因此,对计算机辅导系统的开发者来说,关键问题始终是:人类辅导者在做哪些计算机辅导系统没有做的事?为什么那会使他们更有效?本节回顾若干主要假设。
1. 详细的诊断性评估
一种假设认为,人类辅导者会推断出关于学生能力与误解的准确而详细的模型,然后利用这种诊断性评估(diagnostic assessment)使辅导适应个别学生的需要。这一假设的境遇并不好。虽然人类辅导者通常知道受辅学生尚未掌握哪些正确的知识成分,但他们很少了解学生的错误概念(misconception)、错误信念和有缺陷的技能(M. T. H. Chi, Siler, & Jeong, 2004; Jeong, Siler, & Chi, 1997; Putnam, 1987)。此外,人类辅导者很少提出能够诊断学生特定错误概念的问题(McArthur, Stasz, & Zmuidzinas, 1990; Putnam, 1987)。当给人类辅导者提供关于学生掌握/未掌握情况的信息时,他们的行为会发生改变,并可能变得更有效(Wittwer, Nuckles, Landmann, & Renkl, 2010)。然而,当给他们提供关于学生错误概念、缺陷和错误信念的详细诊断信息时,他们既不改变行为,也不会变得更有效(Sleeman, Kelly, Martinak, Ward, & Moore, 1989)。此外,在一项研究中,当人类辅导者只是与同一名学生长期合作、因而能够诊断出学生的长处、弱点、偏好等时,他们的效果并不比在受辅学生之间轮换、因而对学生始终缺乏了解时更好(Siler, 2004)。简言之,人类辅导者似乎并不会推断出包含错误概念、缺陷或错误信念的学生评估;即便把这样的评估交给他们,他们似乎也不会使用。另一方面,他们有时会推断出学生已掌握了哪些正确的概念、技能和信念,并且当这样的评估交给他们时,他们能够加以利用。在这一点上,人类辅导者的运作方式与许多计算机辅导系统相同,后者也会推断这类评估,即所谓的覆盖模型(overlay model)(VanLehn, 1988, 2008a)。
2. 个性化任务选择
另一种假设认为,人类辅导者比计算机辅导者更有效,是因为他们更擅长挑选恰好是个别学生学习所需要的任务。(这里“任务”指持续数分钟、包含多个步骤的活动,如解一道题、阅读多页课文、做一个虚拟实验室实验等。)事实上,个性化任务选择是美国国家工程院(National Academy of Engineering)一项重大挑战的组成部分(http://www.engineeringchallenges.org/cms/8996/9127.aspx)。然而,研究表明,人类辅导者是按照一种课程脚本(curriculum script)来挑选任务的,即一个由易到难排列的任务序列(M. T. H. Chi, Roy, & Hausmann, 2008; Graesser, Person, & Magliano, 1995; Putnam, 1987)。人类辅导者利用其对学生在正确知识方面掌握情况的评估,来调节自己沿课程脚本推进的速度。事实上,正如刚才所论证的,鉴于他们很可能缺乏对学生深入的、基于错误概念的评估,他们也很难有别的做法。一些计算机辅导系统与人类辅导者一样使用课程脚本,另一些则使用更加个性化的任务选择方法。因此,按照这一论证,计算机辅导应当比人工辅导更有效。简言之,个性化任务选择并不是解释人工辅导卓越有效性的好理由。
3. 复杂的辅导策略
另一种常见的假设是,人类辅导者使用复杂的策略,例如苏格拉底式反讽(Socratic irony)(Collins & Stevens, 1982),即引导给出错误答案的学生看到该答案会导出一个荒谬的结论。其他此类策略包括互惠教学(reciprocal teaching)(Palinscar & Brown, 1984)和探究法(inquiry method)。然而,对具有各种专业程度、分布在许多任务领域中的人类辅导者的研究表明,这类复杂策略很少被使用(Cade, Copeland, Person, & D’Mello, 2008; M. T. H. Chi, Siler, Jeong, Yamauchi, & Hausmann, 2001; Cho, Michael, Rovick, & Evens, 2000; Core, Moore, & Zinn, 2003; Evens & Michael, 2006; Fox, 1991, 1993; Frederiksen, Donin, & Roy, 2000; Graesser et al., 1995; Hume, Michael, Rovick, & Evens, 1996; Katz, Allbritton, & Connelly, 2003; McArthur et al., 1990; Merrill, Reiser, Merrill, & Landes, 1995; Merrill, Reiser, Ranney, & Trafton, 1992; Ohlsson et al., 2007; VanLehn, 1999; VanLehn, Siler, Murray, Yamauchi, & Baggett, 2003)。因此,复杂的辅导策略无法解释人类辅导者相对计算机辅导者的优势。
4. 学习者对对话的控制
另一种假设是,人工辅导允许混合发起(mixed initiative)的对话,学生可以提问或改变话题。这与大多数辅导系统形成对照,在后者中学生的主动性受到高度限制。例如,学生虽然可以向典型的 ITS 请求某一步的帮助,但不能提出其他任何问题,也不能让辅导系统偏离解题进程。相反,学生可以自由地向人类辅导者提出任何问题,并与辅导者协商转换话题。然而,对人类辅导对话的分析发现,虽然学生比在课堂情境中更多发起主动,但频率仍然很低(M. T. H. Chi et al., 2001; Core et al., 2003; Graesser et al., 1995)。例如,Shah, Evens, Michael, and Rovick (2002) 发现在 28 小时的键盘输入式人工辅导中,学生主动发起仅有 146 次,而且这 146 次中有 37% 只是学生在询问辅导者自己的陈述是否正确(例如在陈述末尾加上“对吗?”)。也就是说,大约每 18 分钟才有一次非平凡的学生主动发起。参与者是作为高风险生理学课程一部分而接受辅导的医学生,因此冷漠不太可能是他们提问率低的解释。简言之,学习者对对话的更大控制并不是人类辅导者比计算机辅导者更有效的合理解释。
5. 更宽广的领域知识
人类辅导者对学科内容(领域)的了解通常比计算机辅导者广得多、深得多。大多数计算机辅导系统只“知道”如何求解并指导布置给学生的任务。人类辅导者原则上还能讨论许多相关的思想。例如,如果学生觉得领域的某条原理反直觉,人类辅导者可以讨论该原理的历史,解释支持它的实验证据,并讲述其他学生起初也觉得这条原理反直觉而现在却觉得十分自然的轶事。这样的讨论远远超出大多数计算机辅导系统的能力。然而,当人类辅导者教授认知技能时,这类讨论很少发生(McArthur et al., 1990; Merrill et al., 1995; Merrill et al., 1992)。当人类辅导者教授程序性较弱的内容时,他们的确常常给出比计算机辅导系统更深入的解释(M. T. H. Chi et al., 2001; Evens & Michael, 2006; Graesser et al., 1995),但 M. T. H. Chi et al. (2001) 发现,抑制这类解释并不影响受辅学生的学习收益。因此,尽管人类辅导者的知识确实比计算机辅导系统更宽广、更深入,但他们在辅导中有时并不把它表达出来;即便表达出来,似乎也不会带来显著更大的学习收益。
6. 动机
人工辅导的有效性或许可以归因于提高了学生的动机。在人工辅导中,看似旨在提高学生动机的情节相当常见(Cordova & Lepper, 1996; Lepper & Woolverton, 2002; Lepper, Woolverton, Mumme, & Gurtner, 1993; McArthur et al., 1990),但它们对学生学习的影响并不清楚。
例如,考虑表扬(praise)。Lepper et al. (1993) 把表扬列为提高动机的关键辅导策略。人们可能认为,人类辅导者的表扬提高了动机,动机提高了投入,投入又提高了学习;而计算机的表扬对学习的影响可能很小甚至为负。然而,人类辅导者的表扬对受辅学生的效应实际上相当复杂(Henderlong & Lepper, 2002; Kluger & DeNisi, 1996)。在某些情形中,表扬甚至与学习收益的减少相关联(Boyer, Phillips, Wallis, Vouk, & Lester, 2008)。目前尚不清楚人类辅导者究竟何时给予表扬,也不清楚其对学习的影响。
再举一例,人们常认为,人类辅导者仅仅在场就会使学生降低学习意愿(即所谓“温暖身体”效应(warm body effect))。如果真是这样,那么以文本为媒介的人工辅导就应当比面对面的人工辅导更有效。即便文本媒介的辅导是同步的(即聊天,而非电子邮件),它所提供的“温暖身体”效应似乎理应更弱。然而,Siler and VanLehn (2009) 发现,虽然文本媒介的人工辅导耗时更多,但其学习收益与面对面人工辅导相同。Litman et al. (2006) 将文本媒介的人工辅导与非面对面的口头人工辅导作了比较(参与者通过全双工音频交流并共享屏幕)。人们本预期口头辅导比文本媒介辅导提供更多的“温暖身体”效应,但两者学习收益的差异并不显著,尽管趋势与预期方向一致。
再举一例,Lepper et al. (1993) 发现,一些辅导者对错误的答案也给予正面反馈。他们推测,尽管虚假的正面反馈可能实际上损害了学习,辅导者使用它是为了提高学生的自我效能感(self-efficacy)。
简言之,尽管表扬、“温暖身体”效应、虚假正面反馈等动机性策略在人工辅导中很常见,但在这些研究所测量的意义上,它们似乎对学习没有直接影响。因此,动机性策略并不能为人工辅导优于计算机辅导提供合理解释。
7. 反馈
另一种假设是,人类辅导者既帮助学生监控自己的推理,也帮助他们修复缺陷。只要学生看上去在取得进展,辅导者就不干预;而学生一旦卡住或犯错,辅导者就能帮助学生弥补知识缺口、重新前进(Merrill et al., 1992)。在 CAI 情境下,学生可能先产出一条长达数分钟的推理链,最后得到一个错误答案,然后很难找出推理中的错误并修复知识。然而,人类辅导者鼓励学生边做边解释自己的推理,并且通常在一听到不正确的推理时就进行干预(Merrill et al., 1992)。有时即便学生说出的推理是正确的、只是语气不确定,他们也会干预(Forbes-Riley & Litman, 2008; Fox, 1993)。由于人类辅导者能在学生发生心理错误后如此迅速地给出反馈和提示,学生识别有缺陷的知识应当容易得多。简言之,人工辅导的高频反馈使学生更容易发现推理中的缺陷并修正自己的知识。与前面六种假设不同,这一假设似乎是对“人工辅导为何比计算机辅导更有效”的一个可行解释。
8. 支架
人类辅导者为学生的推理搭建支架(scaffold)。这里“支架”取其本义(该术语由 Wood, Bruner, and Ross (1976) 在其对人类辅导对话的分析中提出)。以下是一个较新的定义:
[支架是]一种引导性提示,推动学生沿着同一思路再往前走一点,而不是告诉学生某些新信息、对学生的回答给予直接反馈,或提出一个与学生推理无关的新问题或新议题……需要指出的要点是,支架涉及辅导者与学生(或成人与儿童)的合作执行或协调,其方式使学生能够在执行该技能的过程中承担越来越大的份额。(M. T. H. Chi et al., 2001, p. 490)
例如,假设在学生回答问题“把一个高尔夫球和一根羽毛在真空中从同一地点同时放下,哪一个先碰到真空容器的底部?请解释你的答案。”的过程中发生如下对话:
- 学生:“同时碰到。我看过一段视频。真神奇。”
- 辅导者:“对。为什么会这样?”
- 学生:“不知道。和自由落体有关吗?”
- 辅导者:“对。自由落体中物体的加速度是多少?”
- 学生:“g,即 9.8 m/s²。”
- 辅导者:“对。所有物体自由落体时的加速度都是 g 吗,包括高尔夫球和羽毛?”
- 学生:“哦。那么它们同时开始下落、同时加速,所以必然同时落地。”
辅导者的第 2、4、6 轮都是支架的例子,因为它们延伸了学生的推理。后文还会给出更多支架的例子。
支架在人工辅导中很常见(Cade et al., 2008; M. T. H. Chi et al., 2001; Cho et al., 2000; Core et al., 2003; Evens & Michael, 2006; Fox, 1991, 1993; Frederiksen et al., 2000; Graesser et al., 1995; Hume et al., 1996; Katz et al., 2003; McArthur et al., 1990; Merrill et al., 1995; Merrill et al., 1992; Ohlsson et al., 2007; VanLehn, 1999; VanLehn et al., 2003; Wood et al., 1976)。此外,操纵支架使用与否的实验表明,支架是一种有效的教学方法(如 M. T. H. Chi et al., 2001)。因此,支架是解释人工辅导功效的一个可行候选。
9. ICAP 框架
M. T. H. Chi (2009) 提出的框架(现称 ICAP,M. T. H. Chi, 2011)将可观察的学生行为分为互动的(interactive)、建构的(constructive)、主动的(active)与被动的(passive)四类,并预测其有效性排序为:
互动 ≥ 建构 > 主动 > 被动。
被动的学生行为是指注意所呈现的教学信息而没有额外的身体活动。阅读课文或听讲时的朝向都属于被动行为。主动的学生行为包括“身体上做点什么”(M. T. H. Chi, 2009, Table 1),例如逐字记笔记、在课文上划线或抄写解答。建构的学生行为要求“产出包含超越所呈现信息之想法的输出”(M. T. H. Chi, 2009, Table 1),例如对课文进行自我解释或绘制概念图。互动的行为要求“就同一主题展开大量对话,并且不忽视同伴的贡献”(M. T. H. Chi, 2009, Table 1)。
ICAP 框架意在适用于被观察到的学生行为,而非引发这些行为的教学。人类辅导者有时能引发互动性的学生行为,但并非总是如此。例如,当人类辅导者讲课时,学生的行为是被动的。当辅导者提问而学生的回答纯属猜测时,学生的行为是主动的。当辅导者默默看着学生绘制概念图或解题时,学生的行为是建构的。同样,这四类学生行为原则上在计算机辅导系统中也都会出现。
然而,M. T. H. Chi 对“互动”的定义包括共同建构(co-construction)和其他协作性口语活动,而这些目前超出了计算机辅导的技术水平。这并不必然意味着计算机辅导不如人工辅导有效。注意 ICAP 框架中的”≥“号:有时建构性的学生行为与互动性的学生行为同样有效。原则上,一个能引发 100% 建构性学生行为的计算机辅导系统,可以与一个能引发 100% 互动性学生行为的人类辅导者同样有效。
将 ICAP 框架应用于辅导(或任何其他教学)需要知道互动、建构、主动、被动四类学生行为的相对频率。这需要对观察到的学生行为进行编码。例如,在一项训练时间保持恒定的研究中,如果观察到人工辅导条件下学生行为为 30% 互动、40% 建构、20% 主动、10% 被动,而计算机辅导条件下为 0% 互动、70% 建构、20% 主动、10% 被动,那么 ICAP 将预测两者有效性相等。反之,如果人工辅导条件的百分比为 50% 互动、10% 建构、20% 主动、20% 被动,而计算机辅导为 0% 互动、33% 建构、33% 主动、33% 被动,那么 ICAP 将预测人工辅导比计算机辅导更有效。遗憾的是,无论人工辅导还是计算机辅导,这样的编码至今尚未有人做过。
前面八种假设讨论的是辅导者行为对学习的影响,而这一假设(ICAP 框架)提出的是一个中介变量。也就是说,辅导者的行为改变学生行为的频率,而学生行为又影响学生的学习。因此,即便我们知道互动和建构行为在人类辅导者条件下比在计算机辅导者条件下更常见,我们仍需研究辅导者的行为才能弄清原因。例如,在 ICAP 框架被发现之前,M. T. H. Chi et al. (2001) 就发现支架与某些学生行为相关,这些行为如今会被归为建构性和互动性行为。支架正是假设 8 所指的辅导者行为。原则上,ICAP 框架可以与前八种假设中的任何一种结合,从而对人工辅导与计算机辅导的差异给出更深入的解释;但 ICAP 框架并不是这些假设的替代品。
在列举了若干假设之后,值得花点篇幅澄清它们的差别。反馈(假设 7)与支架(假设 8)是两个不同的假设,但关系密切。反馈发生在学生犯错或陷入僵局之后,而支架是前瞻性的,鼓励学生延展一条推理路线。两者之所以有效,是因为它们都让学生经历一条正确的推理路线,其中大部分推理由学生自己完成,其余部分由辅导者协助。在前述八种假设中,这两种似乎最能解释人工辅导的有效性,也许因为它们不过是同一种协助的前瞻版本与反应版本。
尽管反馈和支架都属于适应性(adaptivity)与个性化的形式,但不应与假设 2 的个性化任务选择相混淆。在这三种情形中,辅导者关于下一步做什么活动的决定都以学生的行为为依据,因此辅导者都在使自己的行为适应学生。然而,相关活动的持续时间不同。在个性化任务选择中,辅导者决定的是一项相对较长的活动,例如让学生解一道指定的题、读几页课文、看一段视频等。而在支架和反馈中,辅导者决定的是保持沉默、给予反馈、给予提示、替学生做下一步等等。Shute (1993) 用两个术语刻画了这一区别:把拥有复杂个性化任务选择方法的计算机辅导系统称为“宏观适应的”(macro-adaptive),把拥有调节支架、反馈及其他短时教学活动之复杂方法的辅导者称为“微观适应的”(micro-adaptive)。
总而言之,在本文讨论的假设中,假设 9(ICAP 框架)与其余所有假设互补,并有可能为辅导者行为如何影响学生学习提供解释。在其余八种假设——详细的诊断性评估、个性化任务选择、复杂的辅导策略、学习者对对话的控制、领域知识、动机、反馈与支架——之中,只有最后两种似乎完全不存在相抵触的证据。假设 6(动机)也许能解释人工辅导的功效,但这样的解释会很复杂。因此,迄今最好的假设是:当人类辅导者比计算机辅导者带来更大的学习收益时,那是因为他们更善于为学生搭建支架、给予反馈,从而促使学生在自我修复和建构知识的过程中表现出互动性与建构性的行为。早先的几篇综述也得出了类似的结论(M. T. H. Chi et al., 2001; Graesser et al., 1995; Merrill et al., 1992)。
交互粒度假设
前几节论证了人工辅导比计算机辅导更有效,是因为人类辅导者比计算机辅导系统更有效地运用反馈和支架。本节考察不同类型的辅导者如何给出反馈和支架,并论证关键差异在于其交互的粒度(granularity)。
粒度是用户界面的一种属性。虽然人工辅导的交互粒度不受任何约束,不同类型的计算机辅导系统却有不同的粒度。粒度指参与者在两次交互机会之间所需完成的推理量。用户界面的颗粒越大,每次交互之间的推理就越多。例如,基于答案的辅导系统给出题目之后,下一个交互机会是学生输入答案之时。因此,这种用户界面的设计使得学生在两次交互之间完成解题所需的全部推理。相反,ITS 在学生解题过程中给予许多与辅导者交互的机会。例如,学生可以填写提示中间步骤的表单,或参与同辅导系统的对话。由于基于答案的辅导系统在两次交互之间要求更多推理,它的交互颗粒比基于步骤的辅导系统更大。
为了说明粒度的一些细微之处,最好借助一个例子。考虑下面这个问题:
在一篮苹果中,40% 的苹果有虫,25% 内部腐烂。假设两事件相互独立,随机选出的一个苹果有虫但未腐烂的概率是多少?
我们先看人类辅导者与学生之间一段假想的键盘输入对话:
- 学生:我卡住了
- 辅导者:我们的事件是“有虫且未腐烂”的苹果,对吧?
- 学生:对。
- 辅导者:这个事件能否分解成两个事件的“与”(AND)、“或”(OR)之类的组合?
- 学生:我看不出怎么分解。
- 辅导者:这样想,如果把“有虫”看作一种事件,“腐烂”看作另一种事件,那么我们的事件就是“有虫”且“未腐烂”。
- 学生:好。
- 辅导者:能用符号写出来吗,比如 P(……)?
- 学生:P(worm & rot)。
- 辅导者:差一点。检查一下你的“腐烂”。
- 学生:P(worm & ∼rot)。
- 辅导者:很好。你知道哪条规则与它匹配吗?
- 学生:P(A&B) = P(A) * P(B)。
- 辅导者:非常好!那么你确定应用这条规则是合法的吗?需要检查什么?
- 学生:A 是“有虫”,B 是“未腐烂”。
- 辅导者:正如我们之前讨论过的,你必须始终记住哪些规则要求独立性。这条规则就是其中之一。要应用 P(A&B) = P(A) * P(B),事件 A 和 B 必须相互独立。
在第 10 轮和第 16 轮,辅导者给出负反馈。在第 6 轮和第 16 轮,辅导者给出解释。在其余各轮,辅导者通过提示需要完成的下一小步推理来为学生搭建支架。请注意每次交互只覆盖多么少的推理。这段对话展示的是细粒度交互。人工辅导并非必然如此。事实上,辅导者或学生可能给出覆盖整个解答的解释,那样的长解释就构成一次大颗粒的交互。然而,人工辅导的“用户界面”并不对交互粒度施加任何约束。
现在考虑一个典型的基于答案的辅导系统。它会有一个让学生输入答案的输入框。如果输入 0.3,学生得到正反馈。如果输入 0.1,辅导系统可能说:“差一点。那是 P(worm & rot)。你要的是 P(worm & ∼rot)。”输入其他任何数可能让辅导系统说:“再试试。”注意,辅导系统只识别对整个解答的尝试,而那是一条很长的推理线。典型的系统还会有两个按钮。“提示”(Hint)按钮给出一些支架,与人类辅导者的支架类似,但意在为学生的推理从头到尾全程提供动力。“解释”(Explain)按钮则呈现完整的解答。同样,提示和解释都指向从题目到答案的整条推理线。简言之,学生的推理、辅导系统的解释以及这一用户界面允许的所有其他交互都指向一条很长的推理线,因此该用户界面的交互粒度很大。
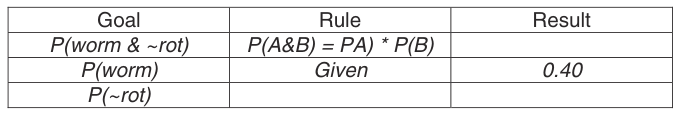
接下来看 ITS,需要区分两种类型。第一类称为基于步骤的辅导系统(step-based tutoring system),因为它的设计目标是让用户输入自己在正常解题(无辅导)情形下会做的步骤(VanLehn, 2006)。例如,如果辅导系统教的是给录像机编程设定录像之类的程序性技能(Mark & Greer, 1995),用户界面就模拟设备的前面板,学生用鼠标点击输入时间、选择电视频道等。另一方面,如果学生通常在纸上做题,用户界面则可能提供一张电子表单,让他们输入“把过程完整写出来”时应当写下的内容。例如,图 2 显示了适用于烂苹果例子的表单,学生已将其部分填好(斜体部分)。假设学生在此处卡住并按下“提示”按钮。辅导系统可能说:“你似乎在求 P(∼rot),但题目只提供了 P(rot) = 0.75。你能想到一条把它们联系起来的规则吗?”如果学生按下“提示”按钮的次数足够多,辅导系统就会解释得出下一步所需的推理,例如:“你需要应用规则 P(A) = 1-P(∼A),在本例中即 P(∼rot) = 1 – P(rot) = 1 – 0.25 = 0.75。”要点在于:学生的输入、辅导系统的提示和解释都指向一条相对较短的推理线。
| 目标(Goal) | 规则(Rule) | 结果(Result) |
|---|---|---|
| P(worm & ~rot) | P(A&B) = P(A) * P(B) | P(worm):已知(Given),0.40 |
| P(~rot):(空白,待填) |
图 2|一个假想的概率学科基于步骤辅导系统所用的表单。
基于步骤辅导系统的颗粒远小于基于答案的辅导系统。
第二类 ITS 称为基于子步骤的辅导系统(substep-based tutor),因为它能在比学生正常解题时输入的步骤更精细的层次上给出支架和反馈。例如,假设一个学生正在编程设定录像机在下午 2 点开始录像,并按下了“提示”按钮。一个基于子步骤的辅导系统可能先问:“你熟悉 24 小时制(军事时间)吗,比如 1600?”如果学生说熟悉,辅导系统就说:“这台录像机使用 24 小时制,所以输入 1400。”如果学生说不熟悉,辅导系统可能用如下多空白表单讲解 24 小时制:
要把上午的时间转换为 24 小时制,只需把小时接在分钟之前,所以上午 9:30 变为 0930。要把下午的时间转换为 24 小时制,小时数加 12 再接上分钟,所以下午 3:30 变为 1530。对于这档电视节目,你要输入下午 2:00 的开始时间。这是_时间,所以你应当把_加到_小时上,然后接上_分钟,最后得到____,这就是你应当输入录像机的数字。
学生通过打字和/或菜单来填空。这些输入在正常操作录像机时并不外显,但它们很可能对应于心理推断。因此,它们是子步骤(substeps)而非步骤(steps)。
这个基于子步骤辅导系统的例子使用的是常规用户界面,通常称为图形用户界面(GUI)或 WIMP(窗口、图标、菜单、指点)用户界面。其他主要的用户界面类型包括命令行、触摸屏和自然语言对话用户界面。原则上,用户界面的类型与用户界面的粒度相互独立。然而,迄今开发的所有基于子步骤的辅导系统都采用自然语言对话用户界面。的确,前面给出的烂苹果对话完全可以由一个基于子步骤的辅导系统来完成,而它也正展示了子步骤的用法。例如,辅导者在第 14 轮追问某一步背后的推理。虽然识别独立性假设在概率解题中至关重要,但学生在仅仅书写步骤时通常不会显式地做这件事。因此,第 14 轮展示了子步骤在自然语言对话用户界面情境中的样子。
为了强调用户界面类型(自然语言 vs. GUI vs. 命令行等)与粒度(答案 vs. 步骤 vs. 子步骤)相互独立这一要点,值得一提的是,基于步骤的辅导系统有时也采用自然语言用户界面。一个很好的例子是 COVE 辅导系统(Roberts, 2001),它是一个 ITS,学生通过说出自然语言命令来输入步骤(如“All engines ahead full.”[全部引擎双车前进])。COVE 教舰艇操舵指挥官(conning officer)如何操纵军舰,因此学生学会说出正确的口令很重要。它的步骤就是自然语言命令,因为那正是学生驾驶军舰时通常要做的事。然而,COVE 并不就学员的推理与他们展开对话。例如,它不会问他们为什么决定下达某个特定命令。因此,尽管采用语音输入,COVE 是一个基于步骤的辅导系统,而不是基于子步骤的辅导系统。虽然还有其他语音输入的基于步骤的辅导系统(如 Core et al., 2006; F. Ritter & Feurzeig, 1988; Stottler & Panichas, 2006; Zachary et al., 1999),但也有语音输入的基于子步骤的辅导系统(D’Mello, King, Stolarski, Chipman, & Graesser, 2007; Litman et al., 2006; Pon-Barry, Schultz, Bratt, Clark, & Peters, 2006)。要点仍然是:用户界面类型与用户界面粒度相互独立。
本综述按交互粒度对辅导系统进行分类,而忽略其用户界面类型(自然语言 vs. GUI 等)。共使用五种颗粒,按大小排序如下:
人工辅导 < 基于子步骤的辅导 < 基于步骤的辅导 < 基于答案的辅导
人工辅导的粒度比基于子步骤的辅导更细,因为其粒度不受约束。基于子步骤的辅导系统的对话是预先规划的、有时是预先编写的,因此其粒度总有一个上限。
如前所述,人工辅导被认为比计算机辅导更有效,是因为人类辅导者更善于给出反馈和搭建支架。如上面的讨论所示,计算机辅导系统同样给出反馈和支架,只是其颗粒比人工辅导更大。这提示,使某一类辅导比其他类辅导更有效的关键属性,可能正是交互的粒度——即用户界面预期在学生与辅导者的两次交互之间发生多少推理。
交互粒度假设(interaction granularity hypothesis)是:辅导系统(包括把人工辅导视为一个“系统”)的有效性随系统交互粒度的减小而提高。这大概是因为参与者围绕越来越小的推理单元和知识单元进行交互,从而使支架、反馈、甚至解释更加有效。这一假设较早的表述把自变量称为“交互性”(interactivity)(VanLehn et al., 2007),而“交互粒度”是它更准确的名称。交互粒度假设预测,不同类型辅导的有效性排序应为:
人工辅导 > 基于子步骤的辅导 > 基于步骤的辅导 > 基于答案的辅导
该假设还可以扩展为:两个交互粒度相同、其他方面完全相同的辅导系统将产生相同的学习收益。特别是,如果 GUI 用户界面与对话式用户界面具有相同的粒度,那么两者应当产生相同的学习收益。例如,COVE 不应比一个用菜单代替语音输入的版本更有效。当然,基于菜单的版本无法让学生练习回忆并说出正确的海军口令,所以只有把比较限定在“知道何时该下达什么口令”(即使口令说得不够标准)上,这种比较才是公平的。这一预测尚未在 COVE 上检验过,但它与数学领域的若干实验一致(Aleven, Ogan, Popescu, Torrey, & Koedinger, 2004; Corbett, Wagner, Lesgold, Ulrich, & Stevens, 2006)。这些实验表明,当基于步骤的辅导系统使用自然语言界面时,它比同一系统使用基于菜单的界面更能提高学生对数学语言的掌握;但如交互粒度假设所预测,两种输入步骤的方式在提高学生解题技能与数学理解方面同样有效。
本综述的范围与方法
第一小节说明纳入本综述的标准;第二小节描述综述的方法。
纳入与排除标准。 为了检验“各类型辅导按有效性排序为人工 > 基于子步骤 > 基于步骤 > 基于答案 > 无辅导”这一假设,只纳入涉及至少两种不同辅导类型的实验。例如,一个实验可以比较人工辅导与无辅导,或比较基于子步骤的辅导与基于答案的辅导。
目前已至少有十几篇综述比较过基于答案的辅导与无辅导(J. A. Kulik, 1994)。因此,只包含基于答案的辅导与无辅导的研究被排除。
本综述只涵盖那些操纵交互粒度(如前文所定义)、同时力图控制其他所有变量的实验。最重要的是,如果控制条件与实验条件接受的内容不同,这类比较就被排除。例如,Carnegie Learning 公司认知导师(Cognitive Tutors)的研究被排除,因为实验条件的学生使用了与比较条件的学生不同的教科书和课堂活动。鉴于这些基于步骤的辅导系统的知名度,值得提及的是:“什么有效证据中心”(What Works Clearinghouse,WWC)认定,三项关于 Carnegie Learning 代数 I 干预的效力研究达到了 WWC 的证据标准,两项研究在保留意见下达到标准(WWC, 2009, 2010)。这些研究的结果好坏不一。采用 WWC 选用的测量,这五项研究的效应量分别为 0.38(S. Ritter, Kulikowich, Lei, McGuire, & Morgan, 2007)、−0.18(Cabalo, Jaciw, & Vu, 2007)、−0.16(Campuzano, Dynarski, Agodini, & Rall, 2009)、0.04(Shneyderman, 2001)和 −0.07(J. E. Smith, 2001)。Carnegie Learning (2010) 对这些研究的综述发现,在 WWC 未选用的测量上存在中等偏大的正向效应。该公司的综述还报告,在若干未被 WWC 纳入的效力研究中也存在中等偏大的正向效应。然而,这些研究都没有控制内容。如果标准化考试聚焦于对照课堂所教的传统内容,而认知导师聚焦于其他内容,那么 WWC 报告的负面结果就可以得到解释。
在以往的辅导元分析中,学科主题一直是一个很强的调节变量。例如,阅读的效应量小于科学、技术、工程或数学(STEM)主题的效应量(Cohen et al., 1982; Fletcher-Flinn & Gravatt, 1995; G. W. Ritter, et al., 2009)。为了减小研究间的方差、让模式得以显现,本综述把被辅导的学科限定为 STEM 主题。具体而言,本综述排除了关于阅读、第二语言、音乐和体育的辅导研究。
此外,本文纳入的所有研究都使用其解答有明确对错之分的任务。如果存在使用不良界定任务的研究(例如以新颖性或创造性为结果变量的设计任务),那么它们的发现可能与本文的发现不同。
只纳入一对一辅导的研究。这排除了两名或多名学生同时与同一名人类辅导者或辅导系统交互的研究。在一个边界案例(Reif & Scott, 1999)中,两名人类辅导者在会议室里巡回指导做物理作业的六名学生。学生之间并不交互,只与辅导者交互。该研究被纳入本综述,因为其方法更接近一对一人工辅导,而不是一名人类辅导者参与少数学生小组讨论的那种一对多处理。
对于人工辅导,辅导者必须是成人学科专家。同伴辅导或跨龄辅导的研究被排除。对辅导者本身的辅导专长没有设限,因为除了受辅学生的学习收益之外,并没有衡量这种专长的既定方法。虽然只纳入有经验的辅导者是可行的,但结果模式可能并无不同,因为几乎没有证据表明,在都是学科专家的前提下,有经验的辅导者显著比无经验的辅导者更有效(Chae, Kim, & Glass, 2005; di Eugenio, Kershaw, Lu, Corrigan-Halpern, & Ohlsson, 2006; Fossati, 2008)。Cohen et al. (1982) 的元分析发现辅导者的经验与其有效性之间没有关系。Clark, Snow, and Shavelson (1976) 发现,给学科专家提供辅导训练和经验并不会使他们更有效。虽然辅导者专长没有被用作排除研究的标准,但讨论部分将重新讨论这一问题。
只纳入将被试随机分配到各条件的实验。把班级随机分配到条件的研究也被纳入,尽管这一设计弱于把学生随机分配到条件的设计。
只有当研究报告了能够计算效应量的测量时才纳入。除每个条件的均值和总样本量之外,还要求提供标准差、标准误、平均标准误、t 统计量或 F 统计量中的至少一项。
为了匹配关于最有效人工辅导形式的通行看法,人工辅导的研究被限定为同步人工辅导。同步指轮次之间没有长时间的延迟,电子邮件或论坛则不然。面对面辅导属于同步,本综述中大多数人工辅导研究采用的都是面对面辅导。一些研究采用了其他形式的同步人工辅导。典型做法是,学生与人类辅导者分处两个房间,或被隔板隔开。他们都能看到同一个共享工作区,但看不见彼此。他们通过全双工音频(例如大声说话让隔板对面听见)或文本“聊天”界面交流。这些研究大多是把人工辅导与基于子步骤的辅导进行比较,因此它们安排人类辅导者使用与计算机辅导完全相同的通信媒介(同为口头或同为键盘输入)。这些研究被纳入综述,因为已有证据表明,基于文本的同步人工辅导虽然更慢,但效果不亚于面对面人工辅导(Siler & VanLehn, 2009)或语音媒介的人工辅导(Litman et al., 2006)。
本综述排除了针对特殊学生群体的辅导研究,如失聪、失明或有学习障碍的学生。虽然在“学习障碍”与“成绩低于年级水平但无障碍”之间存在灰色地带,但本综述的候选研究没有一个落入该灰色地带。
最后,只纳入 1975 年至 2010 年间发表的研究。
方法
本综述试图覆盖所有符合前述标准的研究。共进行了两次检索——非正式检索与正式检索。非正式检索从考察智能辅导系统研究的四个知名发表渠道开始(《国际人工智能教育杂志》(International Journal of AI in Education)、《交互学习环境》(Interactive Learning Environments)期刊,以及“智能辅导系统”(Intelligent Tutoring Systems)与“人工智能教育”(AI in Education)两个会议的论文集)。对这四个渠道所有卷次的摘要应用了纳入/排除标准。阅读选出的文章,并在其参考文献列表中检索更多相关文章。这种经由参考文献列表的递归检索一直持续到不再发现新文章为止。此次检索得到 87 项比较。
正式检索首先用如下条件查询 ERIC:“tutor*” AND “experiment” NOT “peer” NOT “cross-age” NOT “reciprocal” NOT “reading” NOT “L2” NOT “spelling” NOT “vocabulary” NOT “autism”。共得到 1,226 条引文。对摘要应用纳入/排除标准后,滤掉了除 44 篇以外的所有出版物。这 44 篇出版物中有两篇是非正式检索未发现的,它们包含 8 项新比较。接着,用类似条件检索 PsycINFO,得到 197 条引文。对摘要应用纳入/排除标准后只剩 1 篇出版物,未带来新的比较。至此,正式检索被中止,因为它未能找出检索之前已知相关的大部分出版物,也只发现了少量新的相关文献。
由于正式检索被中止、非正式检索不可重复,而且只有一名编码者(作者本人)应用纳入/排除标准,本综述并不符合当前元分析的标准(Cooper, Hedges, & Valentine, 2009)。尽管如此,很可能几乎所有相关研究都已被找到并得到正确分类,这部分是因为作者在辅导研究社区工作了三十多年。
许多实验采用多种学习测量。例如,一个实验可能既有概念后测又有定量后测。本综述报告效应量最大的那项测量。
当一个实验有三个或更多条件时,每一对两两比较都产生各自的效应量。为完整起见,这里报告所有这些比较。例如,假设一个实验有三组:人工辅导、基于步骤的辅导和无辅导。共有三对两两比较,每一对都报告在附录的不同表格中:人工辅导对基于步骤的辅导报告在一张表中,人工辅导对无辅导报告在第二张表中,基于步骤的辅导对无辅导报告在第三张表中。
如前所述,本综述比较四种辅导(一种人工、三种计算机)以及一个教授与辅导条件相同内容的无辅导处理。不同实验采用了不同的无辅导处理,大多数是阅读课文与无反馈解题的组合。很难为无辅导处理开发调节变量或子分类,因为原始文献通常没有完整描述它们。尽管如此,在列出各项研究的附录中,对无辅导控制条件作了简要描述。
三个示例研究
本综述的目标是通过比较五种教学——人工辅导、基于子步骤的辅导、基于步骤的辅导、基于答案的辅导与无辅导——的有效性来检验交互粒度假设。为了厘清这五种类型和该假设,本节评述若干各自至少包含三种辅导类型的研究。
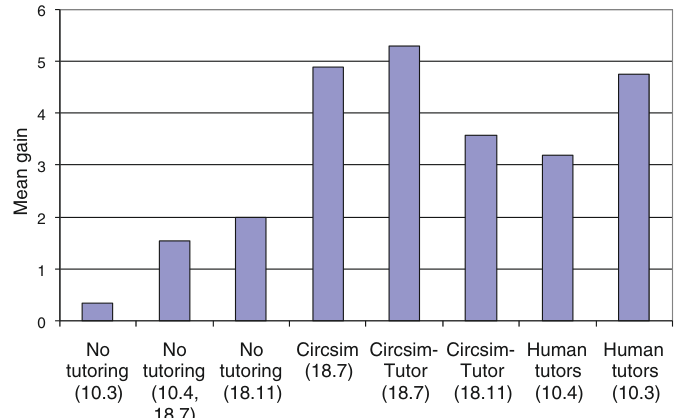
示例 1。 Evens and Michael (2006) 报告并整合了他们所有关于医学生辅导的研究,这些学生正在修心血管生理学课程。他们研究了教学生建立压力感受器反射(baroreceptor reflex)之操作性心理模型的不同方法,该反射控制人体血压。所有学生先学习压力感受器反射的基础知识,然后拿到一个训练问题:人工心脏起搏器发生故障,学生必须填写一张描述身体反应的表格。表的各行是生理变量(如心率;心脏每搏的血液输出量等),各列是时间段。学生在每个单元格中填入 +、− 或 0,以表明该行的变量在该列的时间段内是升高、降低还是不变。填一个格子算作一步,因此这是一个多步任务。学生可以按自己希望的任意顺序填满一整列,然后按下“提交”按钮,针对该列的辅导随之开始。当该列所有单元格都填对后,学生即可开始下一列。
Evens、Michael 及其同事首先开发了一个基于步骤的辅导系统 CIRCSIM。在针对某一列辅导学生时,它指出每一个错误步骤(即填错的单元格),并就该步骤的正确推理给出一段简短的文字解释。由于学生在阅读解释时没有机会与辅导者交互,其用户界面粒度是步骤。
随后,Evens、Michael 及其同事又开发了一个基于子步骤的辅导系统 CIRCSIM-tutor。CIRCSIM-tutor 不是为每个错误步骤打印一段长长的解释,而是进行复杂的键盘输入自然语言对话。虽然默认对话的内容与基于步骤辅导系统打印的解释完全相同,但如果学生的回答表明存在知识缺失或错误概念,对话就会更深入地展开该话题。
CIRCSIM 团队进行了多个实验。一些实验采用无辅导条件:学生阅读包含解决起搏器问题之正确推理示例的课文。一些实验包含通过键盘与学生交互的人类辅导者。虽然其中一个实验使用的是无经验辅导者,其余实验使用的都是两名经验非常丰富的辅导者,他们研究了自己辅导的逐字稿以改进辅导。如果交互粒度假设成立,那么各种处理应排序为:人工辅导 > CIRCSIM-tutor(一个基于子步骤的辅导系统)> CIRCSIM(一个基于步骤的辅导系统)> 阅读课文(无辅导)。
图 3 总结了使用相同测量和训练问题、但教学类型不同的实验结果。交互性最强的三种辅导——人类辅导者、CIRCSIM-tutor 和 CIRCSIM——彼此打成平手。无辅导(阅读)条件与 CIRCSIM、CIRCSIM-tutor 和人类辅导者条件存在差异,但这几个辅导条件彼此之间没有统计差异。这一模式与交互粒度假设不符。
图 3|Evens & Michael (2006) 的结果。 注:条件名称后括号内为 Evens & Michael 书中的表号,因为这些实验未编号(彩色图见在线版)。(纵轴为平均增益,横轴条件依次为:无辅导(10.3)、无辅导(10.4、18.7)、无辅导(18.11)、Circsim(18.7)、Circsim-Tutor(18.7)、Circsim-Tutor(18.11)、人类辅导者(10.4)、人类辅导者(10.3)。)
示例 2。 VanLehn et al. (2007) 研究了概念物理(conceptual physics)辅导。概念物理是一个开放的任务领域,它常常“通过讨论”而非通过解答纸笔多步任务来教学。例如,学生讨论诸如以下的“为什么”问题:
当地球绕太阳公转时,太阳对它施加引力。地球是否也对太阳施加力?为什么是或为什么不是?
在该实验中,这类问答任务被当作多步任务处理。也就是说,对该问题的一个正确而完整的回答被分解为若干关键观点,提到其中一个观点就算一步。例如,回答刚才那个问题需要提到的关键观点中,有两个是“牛顿第三定律”和“作用力—反作用力对”。由于这些步骤是自然语言的,并不要求学生使用一模一样的措辞,但一个完整而正确的解释应当包含这两个步骤以及其他若干步骤。
在实验的所有条件中,学生先学习一篇短教材,然后完成若干任务,每个任务都要求回答一个“为什么”问题(如上所示)。对每个任务,学生先写一篇短文作为初始答案;然后就缺失或错误的步骤接受辅导;最后阅读一篇正确的、写得好的短文。
各处理的不同之处在于,当短文缺失某一步或某一步错误、不完整时,学生接受辅导的方式。共有五种处理,下面按交互粒度从最细到最粗列出:
- 通过基于文本的界面与学生交流的人类辅导者;除少数例外,辅导者是一位职业物理辅导教师,他研究了自己辅导的逐字稿以改进辅导。
- Why2-Atlas,一个基于子步骤的辅导系统。
- Why2-AutoTutor,另一个基于子步骤的辅导系统。
- 一个简单的基于步骤的辅导系统,呈现与 Why2-Atlas 相同的内容,但以文本而非对话的形式呈现。
- 一个控制条件,学生只阅读教材中的段落,不回答概念性问题。
如果交互粒度假设成立,那么预期的有效性排序应为 1 > 2 = 3 > 4 > 5。
图 4 显示了经协方差分析用前测分数校正后的后测分数。颗粒最细的四种辅导(上表中的 1–4)之间没有可靠差异。这四者都比只阅读的无辅导条件(表中的 5)高约 d = 1.0。因此,VanLehn et al. (2007) 的实验 1 和实验 2 并不支持交互粒度假设。
图 4|VanLehn et al. (2007) 实验 1 和实验 2 的结果(彩色图见在线版)。(纵轴为校正后测分数,刻度 0–1;横轴条件依次为:只阅读教材、基于步骤的计算机辅导、Why2-AutoTutor、Why2-Atlas、人工辅导。)
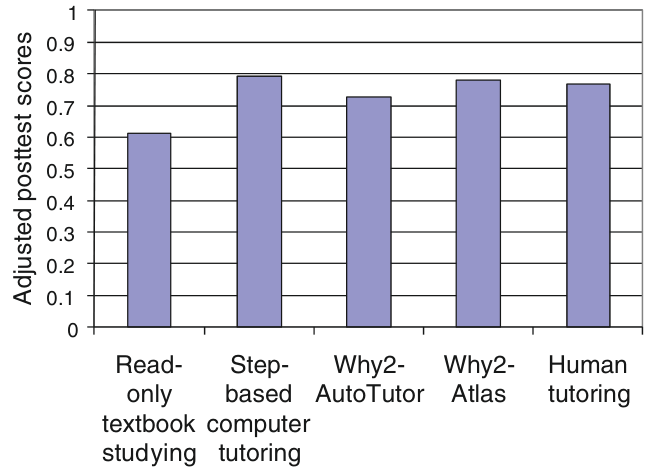
出于对交互粒度假设失效的惊讶,VanLehn et al. (2007) 又做了五个实验。这些实验采用了不同的测量方法(如远迁移、保持),学生的先备知识不同(是否修过大学物理课程),训练问题的数量也不同。除一个实验外,所有实验都观察到相同的结果模式。例外是这样一个实验:未修过大学物理的学生使用了为修过大学物理的学生设计的材料。在该实验中,人工辅导比基于步骤的辅导更有效。研究者查阅辅导逐字稿后得出结论:材料远远超出了学生当前的能力水平。虽然阅读基于步骤辅导系统的补救文本可能不足以理解内容,但人类辅导者能够用新手的语言帮助解释内容。特别是,文本假定读者懂得矢量,而这些新手显然不懂。这一解释与后来的实验一致:后来的实验采用了为未修过大学物理的学生专门彻底重编的材料,并得出了图 4 所示的模式。¹
译注 1(原文脚注 1):在只阅读学习条件(上表中的 5)中,最后两个实验使用的是实验者编写的文本而非市售教材。虽然交互粒度假设预测无辅导教学应当不如辅导有效,但这一无辅导条件的学生获得了与其他条件同样高的学习收益。目前尚不清楚他们为何学得这么好,但可能是由于疲劳较轻,因为他们完成阅读的速度远快于其他还要写作文、与辅导者交互等的学生。
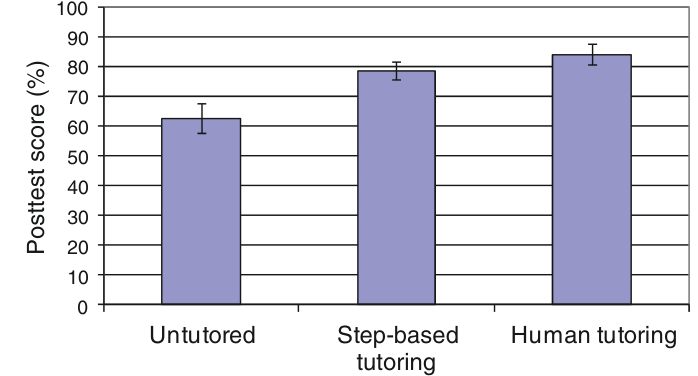
示例 3。 Reif and Scott (1999) 比较了人工辅导、基于步骤的辅导与无辅导。实验中所有学生在同一个物理班;实验只改变学生做作业的方式。共有三种处理。(1) 一组学生在人类辅导者的帮助下做物理作业题。(2) 另一组学生照常在家做作业。由于他们在作业本交回之前得不到任何反馈,这种处理被归为无辅导。(3) 其余学生在基于步骤的辅导系统上做作业。该系统让学生或解一道题,或研究一道已解出的题(例子)。在解题时,学生对每一步都得到即时反馈和提示。在研究例子时,屏幕上依次显示方程、矢量和其他书面记号,每显示一项,学生都要判断它是否正确。这些判断也算作步骤。学生就其步骤获得即时反馈,也可以请求提示。因此,解题与学习例子两种活动都算作基于步骤的辅导。
图 5 显示了 Reif and Scott 的结果。人类辅导者与基于步骤的辅导系统所产生的学习收益没有可靠差异,但两者都可靠地大于无辅导组的收益(人工辅导 d = 1.31;基于步骤辅导 d = 1.01)。
图 5|Reif and Scott (1999) 的结果(彩色图见在线版)。(纵轴为后测分数(%),刻度 0–100;横轴条件依次为:无辅导、基于步骤的辅导、人工辅导。)
然而,人类辅导者与基于步骤的辅导系统都教授了一种有效的问题解决方法(Heller & Reif, 1984),而无辅导学生没有学过这种方法(F. Reif,2009 年 10 月个人交流)。因此,辅导相对无辅导的大收益,部分可能源于教学内容的差异而非教学方法的差异。本综述只关注方法上的差异,所以对于该实验,只纳入人工辅导与基于步骤辅导之间的比较。无辅导条件被忽略,因为它似乎使用了与另外两个条件不同的内容。
结果
与只比较两种教学的大多数元分析不同,本综述比较五种辅导,因此有 10 种可能的两两比较。表 1 列出了全部 10 种。每一行是一种两两比较。
表 1|效应总结
| 比较 | 数目 | 效应量(ES) | 可靠比较比例 | 对应表 |
|---|---|---|---|---|
| 基于答案的辅导 vs. 无辅导 | 165 | 0.31 | 40% | 来自 Kulik & Kulik (1991, 表 3) |
| 基于步骤的辅导 vs. 无辅导 | 28 | 0.76 | 68% | A1 |
| 基于子步骤的辅导 vs. 无辅导 | 26 | 0.40 | 54% | A2 |
| 人工辅导 vs. 无辅导 | 10 | 0.79 | 80% | A3 |
| 基于步骤的辅导 vs. 基于答案的辅导 | 2 | 0.40 | 50% | A4 |
| 基于子步骤的辅导 vs. 基于答案的辅导 | 6 | 0.32 | 33% | A5 |
| 人工辅导 vs. 基于答案的辅导 | 1 | −0.04 | 0% | A6 |
| 基于子步骤的辅导 vs. 基于步骤的辅导 | 11 | 0.16 | 0% | A7 |
| 人工辅导 vs. 基于步骤的辅导 | 10 | 0.21 | 30% | A8 |
| 人工辅导 vs. 基于子步骤的辅导 | 5 | −0.12 | 0% | A9 |
例如,人工辅导可以与其余四种辅导类型逐一比较,因此人工辅导出现在四行中(第 4、7、9、10 行)。基于步骤的辅导同样可以与其余四种辅导类型比较,因此也出现在四行中(第 2、5、6、9 行)。以此方式,每种辅导类型都出现在四行中。
每行内首先给出所综述比较的数目,随后是这些比较效应量的均值。第三个数字是可靠(p < .05)比较所占的比例。一行的最后一列标明附录中列出该行所涉全部比较的表号。
表 1 第一行“基于答案的辅导 vs. 无辅导”与其余各行不同:它报告的是 C. Kulik and Kulik (1991) 综述的结果。该综述把计算机本位教学分为若干类别,其中一个类别在本文中称为基于答案的辅导。表中只报告该类别的平均效应量。可靠比较的比例是一个估计值。虽然 Kulik and Kulik 报告其比较中有 40% 可靠,但他们并未按类别细分。不过,基于答案的辅导研究在该综述中占主导地位(248 项研究中有 165 项被归为基于答案的辅导),因此把 40% 用作表 1 第三列的近似值。
为了解读表 1 中的效应量,先要找到一种有意义的图形展示方式。图 6a 是常规展示:显示表 1 的效应量,每条曲线的左端点位于零点,代表某一处理与其自身比较的效应量。图 6a 使人难以整合结果并确定每种辅导的效应量。例如,假设我们关心的是基于步骤的辅导相对于粒度更低的辅导的有效性。这里有两个相关的点:基于步骤的辅导 vs. 无辅导(0.76)和基于步骤的辅导 vs. 基于答案的辅导(0.40)。虽然可以忽略后一点而直接取 0.76 作为效应量,但这一选择会忽略一部分证据。也可以用如下近似方法为后一点“抬高基线”:
基于步骤 vs. 无辅导 = 基于步骤 vs. 基于答案 + 基于答案 vs. 无辅导 = 0.41 + 0.31 = 0.71
用这种方法,基于步骤与无辅导之差成为 0.71,与直接比较得到的 0.76 相距不远。
图 6|平均效应量。
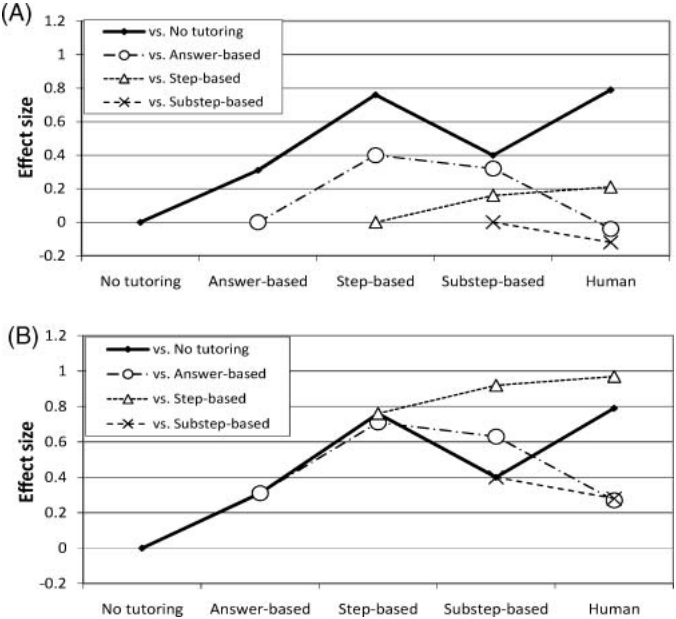
这一“抬高基线”的方法被应用于图 6b 中所有类似的点:把四条曲线的左端点抬高,使它们落在“vs. 无辅导”曲线上。于是,借助效应量相加这一粗略近似,图 6b 中的所有点都是相对于无辅导基线的。例如,图 6b 中有四个点都在估计人工辅导相对于无辅导基线的效应量:
- 人工 vs. 无辅导 = 0.79
- “人工 vs. 无辅导” = 人工 vs. 基于答案 + 基于答案 vs. 无辅导 = −0.04 + 0.31 = 0.27
- “人工 vs. 无辅导” = 人工 vs. 基于步骤 + 基于步骤 vs. 无辅导 = 0.21 + 0.76 = 0.97
- “人工 vs. 无辅导” = 人工 vs. 基于子步骤 + 基于子步骤 vs. 无辅导 = −0.12 + 0.41 = 0.29
图 6b 提示,交互粒度假设只对了一半。当粒度从基于答案降到基于步骤时,有效性从 0.31 提高到 0.75 左右。然而,粒度的进一步降低几乎不再提高效应量。也就是说,似乎存在一个交互高原(interaction plateau)——随着交互粒度减小,效应量先提高,然后趋于平缓。基于一次初步综述,一次会议报告(VanLehn, 2008b)提出了交互高原假设:
人工辅导 = 基于子步骤的辅导 = 基于步骤的辅导 > 基于答案的辅导
这一假设与表 1 和图 6 的效应量大致一致,也与前文描述的示例研究一致(Evens & Michael, 2006; Reif & Scott, 1999; VanLehn et al., 2007)。虽然这些研究的无辅导组的学习显著少于辅导组,但它们的辅导组(基于步骤、基于子步骤和人工辅导)之间没有可靠差异。
图 6b 还有更多意外。第一,人类辅导者相对无辅导的优势似乎是 0.79 个标准差,而不是 Bloom (1984) 研究中的 2.0 个标准差。第二个意外是,基于步骤的辅导几乎与人工辅导一样好,平均效应量为 0.76。虽然最新的技术——基于子步骤的辅导——具有统计可靠性的研究很少,且效应量高低混杂,但图 6b 提示其效应量可能也大致落在 0.75 至 0.80 的同一高原上。
主要结论是:(a) 人工辅导(d = 0.79)并不像我们曾经认为的那样有效;(b) ITS 几乎与人工辅导同样有效(基于步骤 d = 0.76,基于子步骤很可能也是如此);(c) 存在一个交互高原,而不是随粒度减小而持续上升的有效性。
讨论
鉴于人工辅导的平均效应量远低于曾激励起整个领域的 2.0 个标准差,人们可能会怀疑这些研究中的人类辅导者是否有什么问题。具体而言,他们是专家辅导者吗?下一节考察这一问题并简要回顾关于人工辅导专长的文献。再下一节聚焦于效应量特别高的研究,以辨明它们为何非同寻常地成功。其余各节讨论理论意涵、局限以及对未来工作的建议。
专家辅导者与新手辅导者
专家型人类辅导者并没有公认的定义。然而,在许多被综述的人工辅导研究中,作者把他们的辅导者称为专家,其依据往往是辅导者的多年经验。
在上述限制条件下(如 STEM 内容等)的检索发现了若干比较新手与专家辅导者有效性的研究(见附录表 A10),以及若干比较其行为但未测量相对有效性的研究(如 Cromley & Azevedo, 2005; Glass, Kim, Evens, Michael, & Rovick, 1999)。² 几乎所有这些研究都发现,新手辅导者倾向于更多讲授,而专家辅导者的互动性要强得多。
被综述的研究几乎没有提供专家辅导者比新手辅导者更有效的证据。表 A10 列出了相关的专家—新手比较,以及若干操纵辅导者互动程度的研究。虽然部分有效性的绝对差异方向符合预期,但这些比较中只有两个显示出学习收益上的可靠差异。此外,Cohen et al. (1982) 的元分析发现辅导者经验与其有效性无关(前提是他们都是学科专家)。Clark et al. (1976) 发现,给学科专家提供辅导训练和经验并不会使他们更有效。
译注 2(原文脚注 2):一项研究(di Eugenio et al., 2006)分析了辅导者的行为并比较了其有效性,但因无法计算效应量而未纳入元分析。
这些发现与交互高原假设一致。虽然专家人类辅导者比新手辅导者更具互动性,但他们往往并不比新手更有效。而且,把人类辅导者约束得比其自然状态更多或更少互动,对其有效性也没有多大影响。从根本上说,一旦辅导达到了某种交互粒度(大致相当于基于步骤的辅导),交互粒度的进一步减小显然带来递减的、有时甚至可以忽略不计的收益。
为什么有些研究的效应量如此之大?
25 年来,研究者一直在为 Bloom (1984) 的“2 西格玛问题”寻找解决方案。虽然人们会预期许多人工辅导研究显示出 2.0 的效应量,但实际上只有两项研究如此。本节讨论这两项研究,它们如今看来像是离群值。
Bloom (1984) 总结了 Anania (1981) 和 Burke (1983) 的学位论文中报告的六项人工辅导研究。全部六项研究的效应量都接近 2.0。其中只有 Anania 的实验 3 被纳入本综述,因为只有它是一对一辅导。Bloom 总结的另外五个实验都是每名辅导者每天与一个三人小组工作。不过,Anania 的一对一实验确实产生了 1.95 的效应量,所以让我们更仔细地考察它。
对 Bloom 所讨论研究中辅导者有效性的一个常见解释是:他们是受过高度训练的专家辅导者。然而,Bloom 所综述的原始文献表明,这些辅导者是“教育学本科专业的大学生”(Anania, 1981, p. 58),他们在教学开始前“与实验者每天会面,持续一周”(Burke, 1983, p. 85),接受关于辅导和任务领域——概率——的培训。这提示,Bloom 的辅导者并不是人们有时以为的“超级辅导者”。
Anania 的第三个实验(以及 Bloom 的另外五个实验)都包含第三个条件:课堂掌握学习(mastery learning)。也就是说,学生完成一个单元的课堂教学后参加掌握测验。若得分达到 80%,即视为掌握该单元,可进入下一单元;得分低于 80% 的学生必须继续学习该单元并重考掌握测验。在全部六个实验中,掌握学习学生的后测成绩比普通课堂学生高约 1.0 个标准差。此外,全部六个实验的辅导条件也都涉及掌握学习。也就是说,受辅学生参加同样的掌握测验、重新学习等等,只不过他们与一名辅导者而非课堂教师一起工作。然而,辅导条件的掌握阈值被设为 90%,而课堂掌握学习的掌握阈值为 80%(Anania, 1981, pp. 44–45)。也就是说,辅导者对学生掌握程度的要求高于课堂教师。仅这一点就可以解释辅导(2.0 效应量)相对掌握学习(1.0 效应量)的优势。
本综述涵盖的研究中的第二个离群研究是 Evens and Michael (2006, Table 10.3) 的压力感受器实验之一。该实验比较人类辅导者与改为阅读教材的学生,发现效应量为 1.95。该研究的被试很少,因此研究者几年后用更多被试重复了该实验,得到 0.52 的效应量(Evens & Michael, 2006, Table 10.4)。虽然两个实验中受辅学生的平均学习收益大致相同,但第一个实验的对照组(N = 9)的平均收益(0.33)远低于第二个实验对照组(N = 28)的平均收益(1.54)。在另一个比较阅读与计算机辅导的实验(Evens & Michael, 2006, Table 18.11)中,同类对照组(N = 33)的收益为 2.0。虽然各实验的测量之间存在细微差异,但第一个小样本实验的对照组的平均学习收益似乎异常低,也许源于抽样假象。
无论如何,Anania 研究与第一项 Evens and Michael 研究的 1.95 效应量都远高于其他任何“人工辅导 vs. 无辅导”的研究。次高的效应量是 0.82。简言之,人工辅导通常并不像 Bloom (1984) 的六项研究让我们相信的那样比课堂教学高出 2 个标准差,而是更接近本文发现的平均效应量 0.79。当然,这仍然是一个很大的效应量。
虽然 Bloom 的“2 西格玛”文章如今看来展示的更多是掌握学习的力量而非人工辅导的力量,但它激发了一代关于人工辅导与计算机辅导的研究,极大地增长了我们的知识,完全值得付出努力。例如,这些研究产生了许多宝贵的、经过转录和分析的辅导对话语料库,为理解人工辅导提供了大量洞见。Bloom 的 2 西格玛挑战还催生了一项全新的技术——基于对话的辅导——它要求对话管理和鲁棒语言理解方面的进步。这些系统及其他辅导系统如今充当着对动机、交互、协作等许多问题开展严格受控实验的试验台(例子见 http://www.learnlab.org)。
理论意涵
本节为观察到的交互高原构建一种解释。它首先重新审视那两个曾被认为最能解释“人工辅导为何应当比计算机辅导更有效”的假设。这两个假设似乎必然与交互高原假设相冲突,因为它们当初正是被用来支持如今已失去可信度的交互粒度假设的。然而,只需对其假设稍作修订,这两个假设就能导出对高原的一个简单解释。
假设 7 是:人工辅导的反馈帮助学生检测并修复其知识。也就是说,人类辅导反馈促进自我修复(self-repair)。例如,如果一个学生解题时做出成百上千次心理推断,而基于答案的辅导系统说答案不对,那么这成百上千次推断中的任何一次都可能是错的。这使学生很难找出错误的推断并修复知识。基于答案的辅导系统也无法提供多大帮助,因为它同样几乎不知道这上百次推断中哪一次错了。相反,如果人类辅导者在学生做题的过程中不断引出其推理,并指出学生最近的一句话是错的,那么学生就知道最近的推断中有一个是错误的。这些推断最多只有几个,因此自我修复容易得多。所以,当反馈只涉及少数几次推断(人工辅导)时,自我修复远比反馈涉及许多推断(基于答案的辅导)时容易。这就是假设 7 支持交互粒度假设的论证。
而基于步骤的辅导系统就单个步骤给出反馈,或即时给出,或在步骤提交后给出。无论哪种方式,学生都能检查第一个错误的步骤,并知道导致该步骤的推断中必有一个是错的。只要辅导系统确保每个步骤只需要少量推理,那么与基于答案的辅导相比,学生应当更容易找到并修正导致该步骤被判错的推断。此外,基于步骤的辅导系统通常还给予提示,进一步降低学生自我修复知识的难度。于是,只要我们假设学生在基于步骤的辅导中调试一个错误步骤背后的推理,并不比他们在人工辅导中调试一句错误话语背后的推理难多少,“促进自我修复”就为观察到的交互高原提供了一种解释。
假设 8 是:人工辅导为学生搭建支架。这里“支架”指通过协作执行(如提示)与协调(如建立共识(grounding)、共享知识)推动学生沿一条推理路线再前进一步。例如,当人类辅导者对学生说“听起来没问题,继续”时,辅导者既表明了相互理解(协调),又接受了学生的推理(协作执行),还表明了应当由谁继续执行(协作执行)。基于步骤的辅导系统同样为学生搭建支架,只是方式不同。每当学生输入的步骤被系统判为正确,学生就知道系统理解了该步骤(协调),并且系统赞同该推理(协作执行)。当学生卡住时,人类辅导者和基于步骤的辅导系统都会提供提示,让学生重新动起来。如果这些仍不足以让学生脱困,两者都会替学生完成部分推理(协作执行),这在 ITS 文献中称为“到底”(bottom out)提示。因此,当学生卡住时,人工辅导与基于步骤的辅导都会出现显式的协作执行。而基于答案的辅导系统中几乎不发生这种支架。
虽然支架与对自我修复的促进可能对学习有直接影响,但它们可能还有一个同样强的间接影响:使学生更有可能在自行完成大部分推理的情况下正确解完题目。人类辅导者几乎总能让学生正确解完一道题(Merrill et al., 1992)。许多 ITS(即基于步骤和基于子步骤的辅导系统)的支架与自我修复支持非常有力,学生常常能正确完成题目(Schofield, 1995);有些 ITS 甚至要求学生必须正确解出当前题目才能进入下一题(如 Koedinger, Anderson, Hadley, & Mark, 1997)。相反,基于答案的辅导系统所提供的支架和反馈如此薄弱,学生通常在几次尝试失败后就被允许放弃。
这一因素(即自行生成解答 vs. 中途放弃)应当对学习有很大影响。当学生自己完成大部分推理并正确解出一道多步题时,他们要应用数百个知识成分(knowledge components)。每应用一个知识成分,他们都在新的情境中应用它,从而将其泛化;他们从记忆中提取它,从而将其强化。如果他们起初未能提取出恰当的知识成分,通常会建构或重构它(记住,我们假定这是自行生成的正确解答)。类似地,如果他们应用了某个错误概念,最终会意识到错误并改用正确的知识成分。简言之,当学生自行生成正确解答时,他们把解答所需的全部知识成分都泛化、强化、建构和调试了一遍。遗憾的是,当他们早早放弃时,就错过了成百上千次学习机会。
这一解释——所有自行生成的正确解答同样有效——最早由 Anderson et al. (1995) 提出,尽管只针对基于步骤的辅导系统。Anderson et al. 假设,只要学生自行完成大部分推理解出一组题目,那么无论他们的基于步骤的辅导属于哪种形式,其学习收益都相同。Anderson et al. 通过比较其辅导系统的若干不同版本支持了这一假设。例如,有些版本提供即时反馈,有些提供延迟反馈。在大多数这类实验中,当所有实验组的学生都被要求把所有题目全部做对时,实验操纵并不影响其学习收益;另一方面,这些操纵确实影响了效率,即把所有题目全部做对所需的时间。把 Anderson et al. (1995) 的假设扩展到所有类型的辅导,并在上述假设的前提下,就能解释观察到的交互高原。
简言之,本文为交互高原提出的解释是:人类辅导者、基于步骤的辅导者和基于子步骤的辅导者都提供了足够的支架和反馈,使学生对大多数题目都能自行生成正确解答。虽然基于步骤的辅导系统要求学生跨越比更细粒度辅导更大的鸿沟,但学生显然大多数时候都能做到。这既有直接收益也有间接收益。直接收益是,促使学生正确跨越鸿沟的支架和反馈同时促使他们建构或自我修复知识。间接收益是,由于学生坚持求解而不是放弃,他们遇到更多的学习机会。相反,当学生在基于答案的辅导系统下或无辅导时解题,即便得到一些反馈甚至一些支架,也常常无法跨越从起点直到终点的那道长鸿沟。一旦无法跨越鸿沟,他们就错过了学习机会。
这一解释与 M. T. H. Chi (2009) 的 ICAP 框架(前文作为假设 9 讨论过)一致。按照 ICAP 框架,互动性和建构性的学生行为可能同样有效,而主动性和被动性的学生行为效果较差。这里提出的解释与 ICAP 一致。它预测与人类辅导者工作的学生将主要表现出互动性行为,与基于步骤的辅导系统工作的学生将主要表现出建构性行为;而在基于答案的辅导系统下或无辅导的学生则常常表现出猜测和放弃,这充其量属于主动性的学生行为。
局限与建议
在提出实践建议时,必须结合本综述的局限来解读这里的结论,其中一些局限源于纳入/排除标准。例如,这些研究中的研究者都力图控制内容,而在现实世界中,一位受聘来辅导物理的辅导者可能最终在辅导学生数学或阅读。此外,这些研究只测量了学习收益。辅导者还可以提升学生的动机和效率。
另一个局限是,本综述中的一些比较只有很少的实验加以检验。显然需要更多实验。特别是,人工辅导与各类计算机辅导的直接比较将尤其受欢迎。虽然这些研究涵盖了成千上万的学生,但涉及的人类辅导者数量却少得多,因此把结论推广到所有人类辅导者是有风险的。
值得注意的是,本综述中没有一项现场研究用辅导完全取代了全部课堂教学;它们只是用辅导取代或部分取代了单一活动(通常是作业)。课堂上有许多可能对学习收益产生重大影响的教学活动,因此只升级其中一项活动并不能保证整门课程的学习收益大幅提升。不过,如果学生的许多学习发生在做作业的过程中,那么用 ITS 取代纸质作业就可能产生很大的效应量。例如,在四项为期一年的评估中,使用基于步骤的物理辅导系统的学生,其学习收益比在纸上完成同样作业的学生高 d = 0.61(VanLehn et al., 2005)。
在本文的局限之内,一条建议是应当扩大基于步骤的辅导系统的使用。虽然这类辅导系统的开发和维护并不便宜,但这些成本并不随受辅学生的人数而增加。因此,当一个辅导系统被大量学生使用时,其每小时辅导的成本可以远低于成人一对一人工辅导。本综述(同样受其局限约束)的一个推论是:在频繁开设或大班额的 STEM 课程中,应当使用基于步骤的辅导系统(通常用于作业)。
本综述的另一个推论是:人类辅导者仍有改进空间。在数十年的人工辅导研究中,一个常见的观察是:人类辅导者错失了许多帮助学生学习的时机。这一观察偶尔被提及(如 M. T. H. Chi, 1996),却很少得到应有的重视。考虑到他们不过是承担一项快节奏、实时、复杂任务的凡人,这并不奇怪。虽然人类可以在这类任务上逐步改进表现,但这可能需要多年高强度的刻意反思练习;而且,频繁的、具体的针对表现的反馈似乎对改进至关重要(Ericsson & Lehmann, 1996)。虽然一些职业辅导者确实从事辅导实践十年以上,但他们的实践不同于职业运动员、音乐家、棋手、外科医生等人的实践,因为他们可能得不到像其他许多职业人士(尤其是运动员)那样频繁而具体的关于成功与失败的反馈。例如,很少有辅导者会把自己的辅导录成视频并加以分析、寻找改进机会。因此可以说,虽然这些研究中的辅导者被称为专家、拥有多年辅导经验,但与一个能够获得十年持续反馈和反思实践的人所能达到的水平相比,他们也许还算不上真正的专家。
与改进人工辅导相比,改进 ITS(即基于步骤和基于子步骤的辅导系统)的表现应当相对简单。近期研究也发现 ITS 的表现中存在许多教学失误和错失的时机(Baker, 2009; Baker, de Carvalho, Raspat, Corbett, & Koedinger, 2009; Murray & VanLehn, 2006)。仅仅找出并修复现有 ITS 的教学失误,就可能产生 2 西格玛的效应量。这类分析可以部分甚至完全自动化。例如,Min Chi 及其同事发现,可以把一种机器学习技术(强化学习)应用于某个基于子步骤辅导系统的日志数据,以调整控制其教学决策的参数(M. Chi, VanLehn, Litman, & Jordan, 2011, in press)。改进后的辅导系统比原系统有效 d = 0.84。简言之,我们也许很快就会看到自我改进的辅导系统:它们监控自身的过程与结果,以调整自己的辅导策略并使之更有效。
总之,底线是:对 ITS 而言,虽然减小用户界面的粒度似乎不再带来额外收益,但重新设计辅导者—学生交互可能带来可观的额外收益。对人类辅导者而言,虽然仅仅更频繁地与学生互动似乎不带来额外收益,但多年的刻意练习也许能让人类辅导者提高其有效性。值得记住的是:从来没有课堂教师被 ITS 取代,而课堂教学被人工辅导取代却并不罕见,例如在家上学。我们既需要优秀的人类辅导者,也需要优秀的 ITS。
本领域未来的工作方向很明确。辅导研究者应当保留 Bloom 的挑战,努力开发出比无辅导有效 2 个标准差的计算机辅导系统和人类辅导者。
核心要点
20 多年来,辅导领域的研究者一直怀有类似图 1 的心智图像:效应量随辅导交互粒度的减小而单调上升,最终达到 Bloom 的人工辅导 d = 2.0。如前所述,Bloom 的 d = 2.0 效应量似乎主要源于对受辅学生提出了更高的掌握标准。也就是说,受辅学生必须在掌握测验上得 90% 才被允许进入下一单元,而掌握学习课堂条件的学生只需在同一测验上得 80%,课堂对照组的学生也参加测验但不论分数一律进入下一单元。因此,Bloom (1984) 的文章正如 Bloom 本人有意为之的那样,展示的是掌握学习的力量,而不是人工辅导的有效性。
如果图 1 这一熟悉的图像不再得到 Bloom 研究的支持,那么更准确的图像是什么?图 6b 呈现了本文综述的效应量。它表明有效性从 0.31(基于答案的辅导)提高到 0.76(基于步骤的辅导),随后似乎触及一个高原。用户界面粒度的进一步减小(基于子步骤的辅导;人工辅导)并不提高有效性。虽然更多的实验数据仍受欢迎,但图 6b 的交互高原似乎是迄今为止关于各类型辅导相对有效性的最佳图像。
或许最重要的是,这份进展报告还表明:在本文的局限之内,就提高 STEM 主题的学习收益而言,ITS 与成人一对一人工辅导同样有效。为免因这类系统名称中不幸含有“辅导(tutoring)”一词而产生误解,需要说明:这里报告的研究没有任何一项试图用 ITS 取代课堂教师,尽管人类辅导者取代课堂教师的情况并不罕见。如前文所论,应当用 ITS 取代作业、课堂练习以及可能的其他活动,而不是取代整个课堂体验。尽管如此,在其有限的专长领域内,目前可用的 ITS 似乎与人类辅导者一样好。
致谢
我感谢 Michelene T. H. Chi、Dexter Fletcher、Jared Freedman、Kasia Muldner 和 Stellan Ohlsson 的细致阅读与富有启发的评论。本文总结的研究多年来得到海军研究办公室(N00014-00-1-0600)和美国国家科学基金会(9720359、EIA-0325054、0354420、0836012 与 DRL-0910221)的资助。
参考文献
(参考文献共 140 条,此处从略。)
附录
表 A1|基于步骤的辅导与无辅导的比较
| d | 引文与说明 |
|---|---|
| 1.34* | (VanLehn et al., 2007, 实验 2)SBT 用文本补救来指导定性物理解释的生成。NT 为阅读一本教材。 |
| −0.32 | (VanLehn et al., 2007, 实验 6)SBT 用文本补救来指导定性物理解释的生成。NT 为实验者编写的文本。 |
| 1.01* | (Moreno, Mayer, Spires, & Lester, 2001, 实验 1)SBT(Design-a-Plant)指导茎、根、叶的组合。NT 为点击式文本和图形。 |
| 0.98* | (Moreno et al., 2001, 实验 2)与实验 1 几乎相同。 |
| 0.68* | (Moreno et al., 2001, 实验 3)与实验 1 几乎相同,但 NT 为一个讲课的智能体。 |
| 0.61* | (VanLehn et al., 2005)SBT(Andes)指导物理整学期的解题;NT 为纸质作业;结果为 4 年间各实验的汇总。 |
| 0.98* | (Corbett & Anderson, 2001)SBT 指导 Lisp 编程。NT 为在标准 Lisp 环境中做无任何反馈的编程练习。 |
| 1.00* | (Anderson et al., 1995, p. 177)SBT 指导 Lisp 编程。NT 为在标准 Lisp 环境中做无任何反馈的编程练习。 |
| 1.00* | (Anderson et al., 1995, p. 183, 第 1 段)SBT 指导几何定理证明。NT 为纸笔作业。 |
| 1.00* | (Koedinger & Anderson, 1993)SBT(ANGLE)指导几何解题。NT 为纸笔。该结果针对由项目成员授课的班级。 |
| −0.23 | (Koedinger & Anderson, 1993)同上,但该结果针对由非项目教师授课的班级。 |
| 0.61 | (Mendicino, Razzaq, & Heffernan, 2009)SBT(ASSISTments)指导解标准化测验中的数学题。NT 为次日课上讨论的纸质作业。 |
| 0.28 | (Shute & Glaser, 1990)SBT(Smithtown)指导微观经济学探究。NT 为课堂教学。 |
| 1.35* | (Mark & Greer, 1995)SBT 指导给录像机编程。NT 为照指示逐步操作。 |
| 1.27* | (Gott, Lesgold, & Kane, 1996)SBT(Sherlock II)指导故障排查。NT 为排查一个测试台故障的实际经验。 |
| 0.70* | (Timms, 2007)SBT(FOSS)指导速度、距离、时间问题的求解。NT 为无任何反馈地做同样的练习。 |
| 0.94* | (Parvez, 2007)SBT(DesignFirst-ITS)指导 UML 设计。NT 为无反馈地解 UML 设计题。 |
| 0.81* | (Stankov, Rosic, Zitko, & Grubisic, 2008)SBT(TEx-Sys)让学生建构或调试大学计算机科学导论知识的语义网络表示。NT 让学生以“传统教与学过程”进行相同时长(14 周)的学习。 |
| 0.60 | 同上,八年级化学,10 周。 |
| 0.75 | 同上,八年级物理,7 周。 |
| 1.23* | 同上,大学计算机科学导论,14 周。 |
| 0.71 | 同上,大学 BASIC 编程,14 周。 |
| 1.36* | 同上,六年级数学,7 周。 |
| 0.17 | 同上,八年级数学,7 周。 |
| 0.34 | 同上,五年级数学,5 周。 |
| 1.17* | (S. D. Johnson, Flesher, Ferej, & Jehn, 1992; S. D. Johnson, Flesher, Jehng, & Ferej, 1993)SBT(Technical Troubleshooting Tutor)指导学生排除模拟航空电子电气系统的故障。NT 学生用真实而非模拟的电气系统解决同样的排故问题。 |
| 0.57* | (B. G. Johnson, Phillips, & Chase, 2009)SBT(Quantum Accounting Tutor)在学生分析交易时给予指导。NT 学生用纸和教材解决同样的问题。 |
| 0.47* | (Steuck & Miller, 1997)SBT(ISIS)在高中生物情境中教科学探究。这是一项为期一学年的现场研究,涉及 84 个教学班和 1,547 名学生。约一半班级使用该辅导系统,另一半改上常规生物实验课。 |
| 0.76 | 平均效应量 |
注:若某比较在统计上可靠(p < .05),其效应量加粗并带星号。Exp. = 实验;NT = 无辅导;SBT = 基于步骤的(计算机)辅导;UML = 统一建模语言。
表 A2|基于子步骤的辅导与无辅导的比较
| d | 引文与说明 |
|---|---|
| 1.34* | (VanLehn et al., 2007, 实验 2)SSBT(Why2-AutoTutor)指导定性物理解释的生成。NT 为阅读教材。 |
| −0.21 | (VanLehn et al., 2007, 实验 6)SSBT 为 Why2-Atlas。NT 为阅读针对性文本。 |
| −0.44 | (VanLehn et al., 2007, 实验 6)SSBT 为 Why2-AutoTutor。NT 为阅读针对性文本。 |
| −0.32 | (Siler, Rose, Frost, VanLehn, & Koehler, 2002, 实验 2)SSBT 为知识建构对话(KCD);NT 为阅读针对性文本(微型课)。 |
| −0.32 | (Siler et al., 2002, 实验 3)SSBT 为 KCD;NT 为阅读针对性文本(微型课)。 |
| 0.96* | (Lane & VanLehn, 2005)SSBT(PROPEL)教新手编程。NT 为点击式文本。 |
| 0.35* | (Graesser et al., 2004, 表 1, 实验 1)SSBT(AutoTutor 1.1)教计算机素养;NT 为重读教材。 |
| 0.46 | (Graesser et al., 2004, 表 1, 实验 2)SSBT(AutoTutor 1.2)教计算机素养;NT 为阅读教材。 |
| 0.45 | (Graesser et al., 2004, 表 1, 实验 3)SSBT(AutoTutor)与阅读精简版教材比较。 |
| 0.76* | (Arnott, Hastings, & Allbritton, 2008)研究方法辅导系统(RMT)以 SSBT 与 ABT 相结合的方式教研究方法。NT 为同一课程的平行班,但没有偶尔布置的辅导作业。 |
| 1.21* | (Hastings, Arnott-Hill, & Allbritton, 2010)同上,但被试群体不同。 |
| 0.54* | (Craig, Driscoll, & Gholson, 2004, 实验 1)SSBT(AutoTutor)教计算机素养。NT 为观看一段 AutoTutor 会话的视频。 |
| 0.71* | (Craig et al., 2004, 实验 2)SSBT(AutoTutor)教计算机素养。NT 为观看一段 AutoTutor 会话的视频。 |
| 0.53 | (Craig, Sullins, Witherspoon, & Gholson, 2006, 实验 1)SSBT(AutoTutor)教计算机素养。NT 为观看一段 AutoTutor 会话的视频。 |
| 0.28 | (Craig et al., 2006, 实验 2)SSBT(AutoTutor)教计算机素养。NT 为观看一段 AutoTutor 会话的视频。 |
| −0.07 | (Craig et al., 2006, 实验 1)SSBT(AutoTutor)教计算机素养。NT 为 AutoTutor 智能体只讲课、不提问。 |
| 0.59* | (Mendicino & Heffernan, 2007, 实验 1)SSBT(Ms. Lindquist)在课上指导解代数文字题。NT 为课上无反馈的纸笔解题。 |
| 0.54 | (Mendicino & Heffernan, 2007, 实验 2)SSBT(Ms. Lindquist)用作家庭作业。NT 为课上无反馈的纸笔解题。报告了 SSBT 与 CAI 条件合并的结果(Razzaq, Mendicino, & Heffernan, 2008)。 |
| 0.65* | (Katz, Connelly, & Wilson, 2007, 实验 2)SSBT 为对解题后反思问题之答案的讨论;NT 为额外的题目练习。 |
| 0.12 | (Gholson et al., 2009)SSBT(AutoTutor)教八年级学生计算机素养;NT 为同样的内容以独白形式呈现。 |
| −0.20 | (Gholson et al., 2009)SSBT(AutoTutor)教九年级学生计算机素养;NT 为同样的内容以独白形式呈现。 |
| 0.00 | (Gholson et al., 2009)SSBT(AutoTutor)教十年级学生概念物理;NT 为同样的内容以独白形式呈现。 |
| −0.13 | (Gholson et al., 2009)SSBT(AutoTutor)教十一年级学生概念物理;NT 为同样的内容以独白形式呈现。 |
| 1.67* | (Evens & Michael, 2006, 表 18.7)SSBT(CIRCSIM-Tutor 的早期版本)指导医学生学习心脏生理学;NT 为阅读教材。 |
| 0.46* | (Evens & Michael, 2006, p. 356)SSBT(CIRCSIM-Tutor 的最终版本)指导医学生学习心脏生理学;NT 为阅读教材。 |
| 0.49* | (Mendicino & Heffernan, 2007, 实验 3)SSBT(Ms. Lindquist)在课上指导解代数文字题。NT 为课上无反馈的纸笔解题。 |
| 0.40 | 平均效应量 |
注:若某比较在统计上可靠(p < .05),其效应量加粗并带星号。ABT = 基于答案的(计算机)辅导;Exp. = 实验;KCD = 知识建构对话;NT = 无辅导;RMT = 研究方法辅导系统;SSBT = 基于子步骤的(计算机)辅导。
表 A3|人工辅导与无辅导的比较
| d | 引文与说明 |
|---|---|
| 1.95* | (Anania, 1981, 实验 3)HT 一对一教地图绘制。NT 为普通班级。 |
| 0.67* | (Azevedo, Greene, & Moos, 2007)NT 为学习关于血液循环的超文本。HT 在学生学习的过程中给予指导。 |
| 0.65* | (Swanson, 1992)HT 教学生如何操作光学实验。NT 为观看演示。 |
| 0.66* | (M. T. H. Chi et al., 2008)HT 指导物理解题。NT 为学生解题时可观看并模仿一段辅导会话的视频。 |
| 0.82* | (M. T. H. Chi et al., 2008)HT 指导物理解题。NT 为学生解题时有教材可查。 |
| 0.55* | (Azevedo, Moos, Greene, Winters, & Cromley, 2008)NT 为学习关于血液循环的超文本。HT 在学生学习的过程中给予指导。 |
| 0.38* | (Bausell, Moody, & Walzl, 1972)HT 教指数记数法。NT 为时长完全相同的课堂教学。 |
| 1.95* | (Evens & Michael, 2006, 表 10.3)HT 为专家,教医学生压力感受器反射;NT 为阅读教材。 |
| 0.52 | (Evens & Michael, 2006, 表 10.4)同上,但被试更多(此处 N = 53;此前 N = 15)。 |
| −0.24 | (Evens & Michael, 2006, 表 10.6)同上,但用新手辅导者代替专家辅导者。以表 10.3 的控制条件作为比较基准。 |
| 0.79 | 平均效应量 |
注:若某比较在统计上可靠(p < .05),其效应量加粗并带星号。Exp. = 实验;HT = 人工辅导;NT = 无辅导。
表 A4|基于步骤的辅导与基于答案的辅导的比较
| d | 引文与说明 |
|---|---|
| 0.17 | (Suraweera & Mitrovic, 2002, 实验 1)SBT(KERMIT)为数据库设计辅导系统。ABT 为只给出最终答案反馈的版本。 |
| 0.63* | (Suraweera & Mitrovic, 2002, 实验 2)与实验 1 相同,但训练时间更长。 |
| 0.40 | 平均效应量 |
注:若某比较在统计上可靠(p < .05),其效应量加粗并带星号。Exp. = 实验;SBT = 基于步骤的(计算机)辅导。
表 A5|基于子步骤的辅导与基于答案的辅导的比较
| d | 引文与说明 |
|---|---|
| 0.56* | (Heffernan, Koedinger, & Razzaq, 2008)SSBT(Ms. Lindquist)指导解代数文字题。ABT 对最终答案给出反馈,但不要求改正。 |
| 0.41 | (Mendicino & Heffernan, 2007, 实验 1)SSBT(Ms. Lindquist)指导代数文字题。ABT 只对最终答案给出反馈,但不要求改正。结果简报于 Heffernan et al. (2008)。 |
| 0.45 | (Mendicino & Heffernan, 2007, 实验 2)与实验 1 相同,但辅导以家庭作业而非课堂作业的形式进行。 |
| 0.49 | (Mendicino & Heffernan, 2007, 实验 3)与实验 1 相同,但由 3 名课堂教师而非 1 名教师实施。 |
| 0.34* | (Arnott et al., 2008)RMT 的一半模块用 SSBT 教研究方法,另一半用 ABT。 |
| −0.34 | (Hastings et al., 2010)同上;被试群体不同。 |
| 0.32 | 平均效应量 |
注:若某比较在统计上可靠(p < .05),其效应量加粗并带星号。ABT = 基于答案的(计算机)辅导;Exp. = 实验;RMT = 研究方法辅导系统;SSBT = 基于子步骤的(计算机)辅导。
表 A6|人工辅导与基于答案的辅导的比较
| d | 引文与说明 |
|---|---|
| −0.04 | (Herrmann, 1982)在掌握学习教学的情境中,由人类或计算机辅导者就错误答案给出反馈,做法是指引学生去看教学材料中的相应章节。 |
表 A7|基于子步骤的辅导与基于步骤的辅导的比较
| d | 引文与说明 |
|---|---|
| −0.10 | (VanLehn et al., 2007, 实验 1)SSBT(Atlas)指导定性物理解释。SBT 用文本解释学生遗漏的步骤并要求重试。 |
| −0.37 | (VanLehn et al., 2007, 实验 1)与实验 1 相同,但 SSBT 为 AutoTutor。 |
| 0.41 | (VanLehn et al., 2007, 实验 3)与实验 1 相同,但测量更为全面。SSBT 为 AutoTutor。 |
| 0.55 | (VanLehn et al., 2007, 实验 5)与实验 1 相同,但被试为物理新手。SSBT 为 Atlas。 |
| 0.23 | (VanLehn et al., 2007, 实验 5)与实验 1 相同,但被试为物理新手。SSBT 为 AutoTutor。 |
| 0.11 | (VanLehn et al., 2007, 实验 6)与实验 5 相同,但材料经过简化。SSBT 为 Atlas。 |
| −0.13 | (VanLehn et al., 2007, 实验 6)与实验 5 相同,但材料经过简化。SSBT 为 AutoTutor。 |
| −0.11 | (Weerasinghe & Mitrovic, 2006)SSBT(Kermit-SE)用基于子步骤的补救教数据库设计。SBT(Kermit)除改用预制文本补救外与前者完全相同。 |
| 0.11 | (Siler et al., 2002, 实验 1)SSBT(Andes-KCD)教物理时使用基于子步骤的帮助。SBT(Andes)用微型课(文本)代替对话。 |
| 0.24 | (Evens & Michael, 2006, 表 18.7)SSBT(CIRCSIM-Tutor)对生理学活动中出现的错误采用基于子步骤的补救。SBT(CIRCSIM)用文本代替对话。 |
| 0.80 | (Katz et al., 2007, 实验 1)SSBT 为对解题后反思问题的基于子步骤的讨论。SBT 为同样的问题加预制文本解释。 |
| 0.16 | 平均效应量 |
注:Exp. = 实验;SBT = 基于步骤的(计算机)辅导;SSBT = 基于子步骤的(计算机)辅导。
表 A8|人工辅导与基于步骤的辅导的比较
| d | 引文与说明 |
|---|---|
| 0.24 | (Fossati, Di Eugenio, Brown, & Ohlsson, 2008)HT 与 SBT(iList-1)教学生操作链表数据结构。 |
| 0.08 | (Fossati et al., 2009)HT 与 SBT(iList-3)教学生操作链表数据结构。 |
| −0.34 | (Katz et al., 2003, 实验 2)HT 在解完一道物理题后讨论反思问题。SBT 呈现这些问题及文本形式的答案与解释。 |
| −0.28 | (VanLehn et al., 2007, 实验 1)HT 指导学生改进其对定性物理问题的回答。SBT 以点击式文本呈现正确答案。 |
| 1.57* | (VanLehn et al., 2007, 实验 4)与实验 1 相同,但学生尚未修过大学物理。HT 为口头形式。 |
| 0.85* | (VanLehn et al., 2007, 实验 4)同上,但 HT 为键盘输入形式。 |
| −0.07 | (VanLehn et al., 2007, 实验 4)同实验 4 的口头辅导,但材料难度有所降低。 |
| 0.62* | (Rose, Aleven, Carey, & Robinson, 2005)HT 与 SBT 指导学生设计卡诺热机。一名人类辅导者的数据被剔除。 |
| −0.59 | (Evens & Michael, 2006, 表 18.7 与表 10.4)HT 指导医学生做心脏生理学练习。SBT(CIRCSIM)在学生出错时呈现文本。 |
| 0.03 | (Reif & Scott, 1999; Scott & Reif, 1999)SBT(PAL)让学生在解题与检查例题步骤中的错误之间交替进行。HT 指导学生解题。 |
| 0.21 | 平均效应量 |
注:若某比较在统计上可靠(p < .05),其效应量加粗并带星号。Exp. = 实验;HT = 人工辅导;SBT = 基于步骤的(计算机)辅导。
表 A9|人工辅导与基于子步骤的辅导的比较
| d | 引文与说明 |
|---|---|
| 0.09 | (VanLehn et al., 2007, 实验 1)SSBT(Why2-AutoTutor)与 HT 指导定性物理解释。 |
| −0.17 | (VanLehn et al., 2007, 实验 1)同上,但 SSBT 为 Why2-Atlas。 |
| −0.07 | (VanLehn et al., 2007, 实验 5)SSBT(Why2-Atlas)与 HT 为未修过大学物理的学生指导定性物理解释。 |
| 0.25 | (VanLehn et al., 2007, 实验 5)同上,但 SSBT 为 Why2-AutoTutor。 |
| −0.71* | (Evens & Michael, 2006, 表 18.7 与表 10.4)SSBT(CIRCSIM-Tutor)与 HT 指导一道心脏生理学问题的求解。 |
| −0.12 | 平均效应量 |
注:若某比较在统计上可靠(p < .05),其效应量加粗并带星号。Exp. = 实验;HT = 人工辅导;SSBT = 基于子步骤的(计算机)辅导。
表 A10|专家或高互动人工辅导与新手或低互动人工辅导的比较
| d | 引文与说明 |
|---|---|
| 0.04 | (Fossati, 2008)专家辅导者对新手辅导者。 |
| NS | (Chae et al., 2005)专家辅导者对新手辅导者。 |
| 0.11 | (H. Johnson & Johnson, 1992)由同一批人实施的苏格拉底式辅导与说教式辅导。 |
| 1.00 | (Rose, Moore, VanLehn, & Allbritton, 2001)由同一人实施的苏格拉底式辅导与说教式辅导。 |
| 3.01 | (Evens & Michael, 2006, 表 10.6)专家辅导者对新手辅导者。 |
| NS | (M. T. H. Chi et al., 2001)比较了未受训的辅导者(倾向于讲课)与被约束为只对学生进行提示的同一批辅导者。 |
| S | (di Eugenio et al., 2006)一名专家辅导者比两名不那么专家的辅导者更有效,但他所教的内容似乎与他们不同。顺带一提,那几名新手辅导者并不比若干基于步骤的辅导系统更有效。 |
注:可靠差异加粗。S 与 NS 分别表示显著与不显著,但无法计算效应量。
译注:一、原文图 2 的表单中,规则栏印作“P(A&B) = PA) * P(B)”,疑漏排左括号,应为 P(A&B) = P(A) * P(B),译文按补正后的形式呈现。二、正文图 2 处的提示语“题目只提供了 P(rot) = 0.75”与例题“25% 内部腐烂”(即 P(rot) = 0.25)不一致,且规则“P(A) = 1-P(∼A)”疑为 P(∼A) = 1 − P(A) 之误,均系原文如此,照实译出。三、原文第 4 轮对话“What it the acceleration…”中的笔误(it 应为 is)不影响文义,按正确含义译出。四、PDF 首页为 Taylor & Francis 平台的下载信息与使用条款等出版方声明,非论文正文内容,未予翻译。五、图 1、图 3—图 6 为统计图,其图注已译出,图中数据点/坐标仅能以文字说明者已在图注括号内尽量注明。