 囫囵
知识追踪:程序性知识习得的建模
Knowledge Tracing: Modeling the Acquisition of Procedural Knowledge|Albert T. Corbett & John R. Anderson|User Modeling and User-Adapted Interaction, 4: 253–278, 1995(© 1995 Kluwer Academic Publishers,Printed in the Netherlands;1994 年 12 月 1 日收稿,1995 年 3 月 13 日定稿)
作者信息:Albert T. Corbett,卡内基梅隆大学计算机科学学院人机交互研究所(Human Computer Interaction Institute, School of Computer Science, Carnegie Mellon University),美国宾夕法尼亚州匹兹堡,PA 15213,电子邮件:[email protected];John R. Anderson,卡内基梅隆大学心理学系与计算机科学系(Psychology and Computer Science Departments, Carnegie Mellon University),匹兹堡,PA 15213,电子邮件:[email protected]
摘要:本文描述了对学生技能习得过程中知识状态变化进行建模的一项工作。本研究中的学生借助 ACT 编程导师(ACT Programming Tutor, APT)学习编写短小程序。APT 围绕一个关于编程知识的产生式规则认知模型构建,该模型称为理想学生模型(ideal student model)。这一模型使导师能够与学生一道求解练习,并在必要时提供帮助。在学生操作的过程中,导师还维护着一个估计值,即学生已习得理想模型中每条规则的概率,这一过程称为知识追踪(knowledge tracing)。导师依据这些概率估计向学生呈现个别化的练习序列,直到学生”掌握”每一条规则。本文介绍了这一编程导师、其认知模型以及学习与表现假设,并回顾了一系列检验知识追踪经验效度(empirical validity)的研究,这些研究促成了对该过程的若干修改。目前,该模型在预测测验表现方面已相当成功。本文还讨论了对建模过程的进一步修改,这些修改可能提升表现水平。
关键词:学生建模(student modeling)、学习、经验效度、程序性知识(procedural knowledge)、智能辅导系统(intelligent tutoring systems)、掌握学习(mastery learning)、个体差异(individual differences)
三十年前,三篇影响深远的论文(Bloom 1968; Carroll 1963; Keller 1968)勾勒出了掌握学习的前景。其核心思想是:只要满足两个条件,实际上所有学生都能在一门学科中达到精通:(1) 将学科知识恰当地分析为一个成分技能的层级结构;(2) 组织学习经验,确保学生在挑战层级中更高层技能之前,先掌握前置技能。这是一个令人心动的想法,它在 20 世纪 70 年代深深植根于美国教育之中,尽管其踪迹可以追溯到更早的年代。综述性文章以压倒性的一致性证实,掌握学习比传统教学带来更高的平均学业成就水平(Block & Burns 1976; Guskey & Pigott 1988; Hyman & Cohen 1979; Kulik, Kulik & Bangert-Drowns 1990; Kulik, Kulik & Cohen 1979),但批评者指出,其效应量明显小于预期(Resnick 1977; Slavin 1987),而且关于技能分解的底层假设也存在争议(Resnick & Resnick 1992; Shepard 1991)。
在本文中,我们尝试把一个技能习得的认知模型用于实现掌握学习的目标。我们尝试监控学生在练习复杂认知技能时不断变化的知识状态,对练习序列进行个别化,使学生能够高效地掌握技能,并准确预测学生的表现。我们对学生建模与个别化教学的兴趣,源于过去十年在智能编程导师方面的工作(Anderson, Boyle, Corbett & Lewis 1990; Anderson, Conrad & Corbett 1989; Anderson, Corbett, Fincham, Hoffman & Pelletier 1992; Anderson, Corbett, Koedinger & Pelletier, in press)。这些导师是学生编写短小程序的练习环境。每个导师都围绕底层技能的一个认知模型构建,使导师能够与学生一道求解练习,并对学生的操作提供反馈。这些导师已被证明是有效的学习环境:学生完成一组固定练习所需的时间大大少于自行学习的学生,而后测得分相同甚至更好。本研究试图在这一成功之上更进一步。通过在一个已证明能加快学习的环境中,把学习与表现假设同认知技能的完整模型结合起来,我们希望让所有学生都能在切实可行的时间内达到掌握。
下面几节将描述智能辅导环境、课程、底层认知模型以及学习与表现假设。随后,我们回顾建模过程中一系列由经验数据驱动的改进。这些改进使我们朝目标走完了部分路程,我们还将讨论未来的方向。
1. ACT 编程导师
ACT 编程导师(APT)是一个练习环境,学生在其中用 Lisp、Prolog 或 Pascal 编写短小程序。Lisp 和 Prolog 模块目前用于卡内基梅隆大学的一门自定进度的编程导论课程,Pascal 模块用于匹兹堡一所高中的编程导论课程。图 1 展示了一项 Lisp 练习进行到一半时导师的屏幕显示。学生此前已在右下角窗口中通读了多页课文,现在正在完成与之相应的练习序列。练习描述显示在左上角窗口中,学生的解答显示在其正下方的代码窗口中。导师界面类似于一个结构化编辑器(structure editor)。学生从右侧菜单中选择算子模板,并通过菜单下方的输入缓冲区(type-in buffer)键入标识符和常量。在本例中,学生已经选择了用于定义新 Lisp 算子的 defun 模板。导师识别出这是一步正确的操作,并在代码窗口中为该算子展开模板 (defun <name> (<parameter>) <body>)。
图 1|APT Lisp 导师界面。
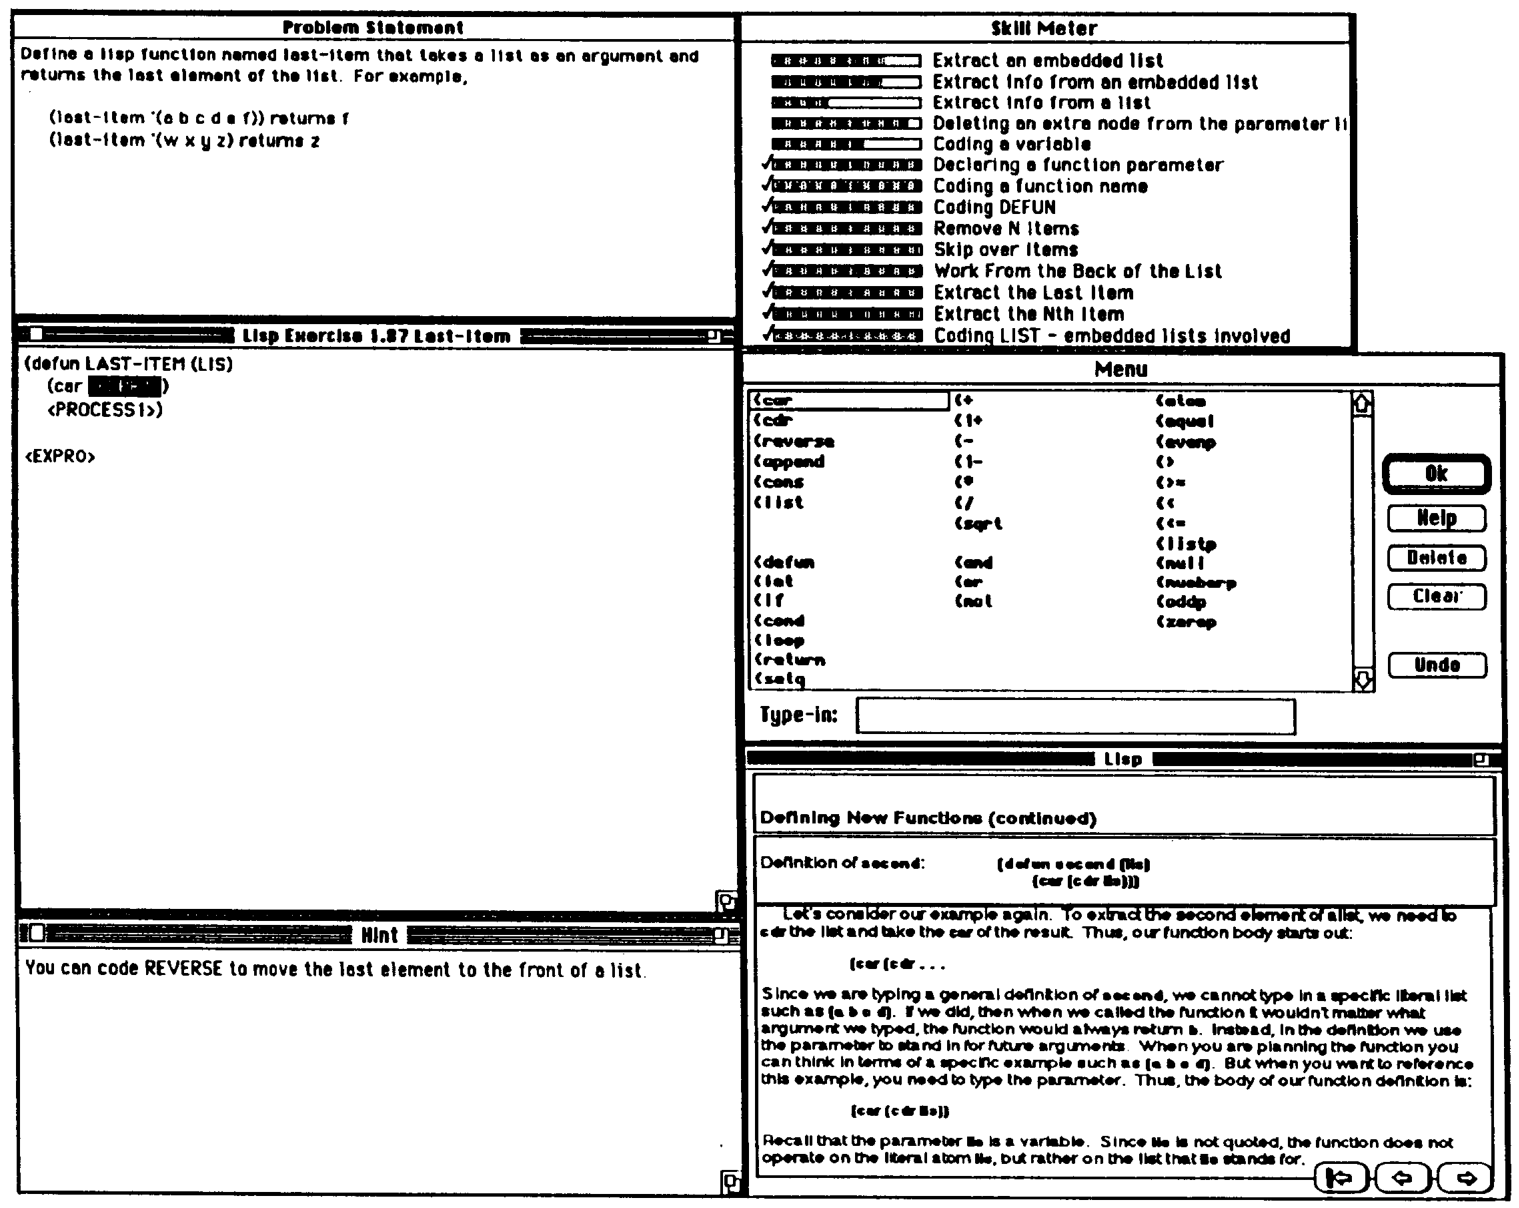
模板中的三个尖括号符号是编辑节点,由学生用 Lisp 代码加以替换。在图 1 中,学生已经:(1) 通过键入函数名 last-item 展开了第一个节点 <name>;(2) 用单个变量 lis 展开了 <parameter> 节点;(3) 用算子模板 (car <expr1>) 展开了函数体 <body>。如该模板所示,car 接受单个参数,由节点 <expr1> 表示。图中该节点被选中(高亮显示),学生可以用 Lisp 代码展开该节点,也可以选择其他节点进行操作。
Lisp 导师围绕一组数百条针对编程的语言特定规则构建,称为理想学生模型。理想学生模型是关于该领域程序性知识的一个完整的、可执行的模型。这些规则以单个符号的粒度表征编程知识,被用于解释学生的操作,这一过程称为模型追踪(model tracing)。在编写程序的每一步,学生的操作都会与理想模型中适用的规则进行比较,并按惯例提供即时反馈。如果学生操作与某条适用规则匹配,导师接受该操作并触发(fire)该规则,更新代码窗口以及问题状态的内部表征。如果学生操作与理想模型中任何适用规则的动作都不匹配,该操作不会记入代码窗口,导师会在左下角的提示窗口中给出一条简短消息。这样,学生始终保持在一条可识别的解答路径上。右上角的技能表(skill meter)显示导师对学生知识状态的建模。这一窗口正是本文的关注焦点。理想模型中的每条规则都由一个条形图表示,阴影部分表示学生知道每条规则的概率。窗口中最上面两条规则的概率约为 0.75,第三条规则约为 0.35。屏幕底部的对勾(checkmark)表示学生已”掌握”了相应的规则。
2. 认知模型
这些导师体现了关于技能知识的 ACT-R 理论(Anderson 1993)。该理论假设陈述性知识(declarative knowledge)与程序性知识之间存在根本区别。陈述性知识是事实性或经验性的。例如,Lisp 课文中的下面这句话及其示例会以陈述性形式编码:
Lisp 函数 car 接受一个列表作为参数,并返回其第一个元素。例如, (car ’(a b c d)) 返回 a
相比之下,程序性知识是目标导向的,并调节问题解决行为。ACT-R 假设技能知识最初通过阅读等经验以陈述性形式编码。在练习早期,学生通过把一般性程序规则应用于这些领域特定知识来解决问题。作为这一早期活动的结果,领域特定的程序性知识被习得。随着后续练习,陈述性知识与程序性知识都得到增强,表现因此变得更加迅速、可靠。
与许多认知理论一样(参见 Kieras & Bovair 1986; Newell 1990; Reed, Dempster & Ettinger 1985),ACT-R 假设程序性知识可以表征为一组相互独立的产生式规则(production rules),它们把问题状态和问题解决目标与动作及相应的状态变化关联起来。下面两条目标导向的产生式,可以分别通过练习书写函数调用和求值函数调用,从上述陈述性示例中推导出来:
IF 目标是写出一个返回列表第一个元素的表达式, THEN 编码算子 car,并设定子目标:把该列表作为参数加以编码。
IF 目标是求值 car 应用于一个列表, THEN 写出列表中的第一个元素。
每个编程导师都包含大量编写程序的规则,以单个符号的粒度对问题解决建模。例如,编写图 1 所示练习的完整解答要用到六条产生式:
(defun last-item (lis) (car (reverse lis)))
图 2 展示了支配这一定义中六个符号的六条产生式规则。第一条产生式匹配由问题描述建立的目标。它触发后会建立一些子目标,这些子目标由后续规则依次满足。我们把内置于导师中的这组编程规则称为理想学生模型,因为它体现了学生试图习得的知识。这一理想模型在导师中扮演两个角色。第一,如上所述,它使导师能够与学生一道逐步求解练习,我们把这一过程称为模型追踪。学生每输入一个代码符号,导师都会尝试把该动作与模型中某条适用规则相匹配。若找到匹配,导师接受该符号并更新其对问题状态的内部表征;若无匹配,导师要求学生尝试别的动作。第二,在知识追踪中,学生被表征为理想模型的一个覆盖层(overlay)(Goldstein 1982)。随着学生完成练习,导师维护着一个估计值:学生已经学会理想模型中每条规则的概率。
| 产生式规则 | 动作 |
|---|---|
| IF 目标是定义一个新的 Lisp 算子,THEN 编码 defun,并:设定目标——编码算子名;设定目标——声明所有变量;设定目标——编码函数体。 | Code defun |
| IF 目标是编码函数名,THEN 键入函数名。 | Type last-item |
| IF 目标是声明变量,THEN 为将要传给函数的每个参数键入一个变量。 | Type lis |
| IF 目标是提取列表的最后一个元素,THEN 编码 car,并设定目标——把最后一个元素移到列表前端。 | Code car |
| IF 目标是把最后一个元素移到列表前端,THEN 编码 reverse,并设定目标——编码该列表。 | Code reverse |
| IF 目标是编码一个绑定到某变量的列表,THEN 键入该变量。 | Type lis |
图 2|编写图 1 中程序 last-item 时适用的六条规则。
2.1 检验 ACT-R 的程序性知识假设
我们辅导研究的主要目标之一,是检验 ACT-R 的这一假设:程序性知识映射到相互独立的产生式规则上。有三类结果为该假设提供了支持:
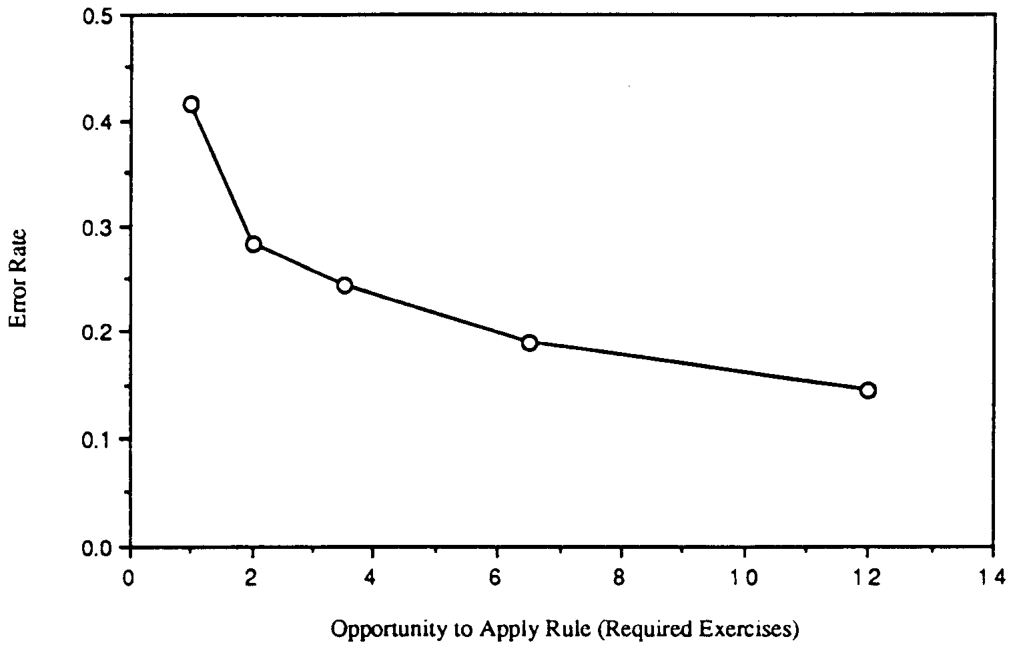
- 产生式规则模型为学习趋势提供了规则性的分析。图 3 展示了 Lisp 导师课程第一课所引入的产生式规则的平均学习曲线。图中,错误率被绘制成规则练习量的函数。在首次应用每条规则的机会上,错误率平均约为 0.42,随后随应用机会的增加而单调下降。如果按其他更表层的单位聚合数据——例如按练习聚合、按练习内的问题解决目标聚合,或者按与问题解决情境无关的各个表层 Lisp 构造的使用机会聚合——则得不到系统性的学习曲线(Anderson, Conrad & Corbett 1989)。Kieras & Bovair (1986) 提供了类似证据,表明产生式规则分析能产生系统性的学习数据。
图 3|Lisp 导师课程第一课所引入编码规则的平均学习曲线。图中绘制的是连续应用规则各机会上的平均错误率。
产生式规则分析已被证明能成功预测编程语言之间的迁移(Anderson, Conrad, Corbett, Fincham, Hoffman and Wu 1993)以及文本编辑器之间的迁移(Singley & Anderson, 1989)。
多种结果支持程序性知识具有目标特定性(goal-specific)这一假设。例如,考虑前文描述过的关于 car 简单用法的两条产生式规则:
IF 目标是写出一个返回列表第一个元素的表达式, THEN 编码算子 car,并设定子目标:把该列表作为参数加以编码。
IF 目标是求值 car 应用于一个列表, THEN 写出列表中的第一个元素。
它们源自同一陈述性知识,但一条特定于书写函数调用,另一条特定于求值函数调用。多项研究表明,在这两种编程技能之一上的练习对另一种技能没有迁移(Kessler 1988; Anderson, Conrad & Corbett 1989; McKendree & Anderson 1987),或者至多只有有限迁移(Pennington & Nicolich 1991)。在微积分领域也获得了关于使用特定性(use-specificity)的类似证据(Singley 1986)。
3. 知识追踪与掌握学习
编程导师在过去十年中已被证明是成功的。学生完成练习所需的时间最少可降至三分之一,同时在测验中表现相同甚至更好(Anderson, Corbett, Koedinger & Pelletier, in press; Anderson & Reiser 1985)。尽管有这一总体上的成功,我们早就认识到有些学生在学习中步履维艰。这促使我们把知识追踪纳入导师,以实现掌握学习。回顾一下:在模型追踪中,认知模型被用于解释学生的每一个动作,并跟随学生穿过问题空间的逐步路径;这一过程的首要目标是提供学生所需的任何指导,使其问题解决得以成功收尾。相比之下,在知识追踪中,我们试图监控学生在练习过程中不断变化的知识状态。在知识追踪中,学生模型是理想学生模型的一个覆盖层。每当学生获得一次应用模型中某条规则的机会,导师都会依据学生的动作,更新其对学生是否知道该规则的估计。
如前所述,ACT-R 的学习假设是复杂的。学生既习得不依赖目标的陈述性知识,又习得目标导向的程序性规则。随着练习,陈述性与程序性知识都在记忆中得到加强,学生的表现变得更可靠、更迅速(Anderson 1993)。在学生练习时在线建模这些关系,计算代价高昂,而且导师所能提供的相对稀疏的数据也不足以支撑这种建模。因此,在导师的知识追踪中,我们代之以一组更简单的学习与表现假设。
知识追踪假设一个两状态学习模型。每条编码规则要么处于已习得状态,要么处于未习得状态。一条规则可以在练习之前通过阅读课文从”未习得”转变为”已习得”,也可以在练习中每一次应用该规则的机会上发生这种转变。不存在遗忘;规则不会向相反方向转变。规则应用的表现由其学习状态决定,但只是概率性的。即使规则处于已习得状态,学生仍可能失误(slip)而犯错;若规则处于未习得状态,学生也有一定机会猜对。随着学生练习,导师为每条规则维护 p(L) 的估计值,即该规则处于已习得状态的概率。在问题解决中每一次应用规则的机会上,依据学生的动作正确与否,更新该规则的 p(L) 估计。这一贝叶斯计算程序是 Atkinson (1972) 所述方法的一个变体。该程序使用两个学习参数和两个表现参数,如图 4 所示。这些参数针对每条规则进行经验估计。
| 参数 | 名称 | 描述 |
|---|---|---|
| p(L0) | 初始学习(Initial Learning) | 在第一次应用规则的机会之前(即通过阅读课文),规则处于已习得状态的概率。 |
| p(T) | 习得(Acquisition) | 在一次应用规则的机会之后,规则从未习得状态转变为已习得状态的概率。 |
| p(G) | 猜测(Guess) | 当规则处于未习得状态时,学生猜对的概率。 |
| p(S) | 失误(Slip) | 当规则处于已习得状态时,学生失误(犯错)的概率。 |
图 4|知识追踪中的学习与表现参数。
知识追踪用如下方程更新对学生知识状态的估计:
p(Ln) = p(Ln − 1 ∣ evidence) + (1 − p(Ln − 1 ∣ evidence)) × p(T)
第 n 次应用规则机会之后规则处于已习得状态的概率 p(Ln),是两个概率之和:(1) 在证据(第 n 个动作正确与否)条件下,理想规则已经处于已习得状态的后验概率;(2) 若规则尚未处于已习得状态,它将转变为已习得状态的概率。我们用贝叶斯推断方案来估计后验概率 p(Ln − 1 ∣ evidence)。依照 Atkinson (1972),在程序性练习期间从未习得状态转变为已习得状态的概率 p(T),与学生应用规则正确与否无关。言语学习研究表明,贝叶斯补救算法是成功的,例如在学习一组相互独立的词对时(Atkinson 1972; Atkinson & Paulson 1972)。与随机选择练习刺激或由学生自选练习刺激相比,这类算法能带来更高的表现水平。
导师运用知识追踪来实现掌握学习。在导师课程的每一节中,学生先阅读介绍一组编码规则的课文,导师随后提供一组针对这些规则的练习。练习序列根据学生的需要量身安排,学生持续练习该节的练习,直到该节引入的每条规则都达到标准知识概率。导师中的这一掌握标准是知识概率 0.95。这一程序与基于 Keller 个性化教学制(Personalized System of Instruction)的个别化、学生自定进度的掌握学习系统类似,后者已被证明能有效提高平均成就分数(Block & Burns 1977; Kulik, Kulik & Bangert-Drowns 1990; Kulik, Kulik & Cohen 1979)。不过,在那些系统中,练习与评定通常被当作两个不同的阶段:学生经历”学习/测验”循环,直到达到标准测验表现水平。相比之下,在知识追踪中,评定被持续地整合进练习之中;学生只是不断练习,直到达到一个假想的知识状态。测验可用于验证掌握决策,但并不参与掌握决策的作出。
值得注意的是,以这种方式表述时,学生建模是一个相对简单的过程。第一,知识追踪的学习与记忆假设是最简单不过的。第二,我们试图避免对学生错误概念(misconceptions)建模的种种复杂性(Duncan, Brna & Morss 1994; Self 1988; VanLehn 1990)。第三,掌握学习简化了一个潜在复杂的规则归属(rule-attribution)问题。由于学生在课程推进过程中逐步掌握前置技能,我们在追踪每个学生动作时只需给单条产生式记分。在下节所述的研究中,我们关心的是:知识追踪能否使学生掌握一项知识密集型技能的各个成分,以及模型预测学生表现的准确程度如何。
4. 知识追踪的实证评估
知识追踪的目标是估计学生的知识,并以很高的概率确保每条规则处于已习得状态。然而,只有当模型能准确预测学生的编程行为时,这一过程才有意义。本节描述评估学生建模过程心理学效度的四项研究。建模假设使我们能够预测每个问题解决步骤上正确动作的概率,第一项研究考察模型预测学生完成导师练习表现的准确程度。这项研究促使我们大幅修订初始认知规则集,并调整学习与表现参数估计。其余三项研究考察了模型预测测验表现的外部效度。知识追踪最终是否有用,取决于它能否预测学生独立工作时的表现。在这些研究中,我们关注学生在没有辅导帮助的情况下正确编写程序的能力。这三项研究中的第一项揭示出,需要在模型中纳入学习与表现参数的个体差异;最后两项研究评估了实现这一目标的一种程序。
4.1 总体实验程序
四项研究都以 Lisp 导师课程的第一章为对象。本章介绍两种数据类型——原子(atom,即符号)和列表(list,符号的层级组合),以及函数调用与函数定义。本章介绍三个一元函数 car、cdr、reverse(它们从列表中提取信息或对列表加以变换),三个构造函数 append、cons、list(它们构建新列表),以及用于定义新函数的算子 defun。课程结构在各研究之间有所演变,但在每项研究中,本章都划分为若干节。在每一节中,学生先阅读课文,然后完成一组固定的必修练习(required exercises)。在学生完成这些必修练习的过程中,导师监控学生对相关编程规则不断增长的知识。随后,导师按需呈现补救练习(remedial exercises),使学生掌握该节引入的规则。当然,补救练习的数量与序列因人而异。学生在研究期间还要完成一次或多次测验(quiz)。每次测验要求学生完成与导师练习类似的额外编程练习,但没有任何辅导辅助。第一项研究的主要目标是考察模型对导师环境中逐目标表现的预测准确程度,并据此调整模型。其余三项研究则处理最终目标:预测学生在导师环境之外独立工作时的表现。
4.2 内部效度:预测导师表现
学生使用导师时,每个编程动作都会得到即时反馈。由于导师不接受错误的编程动作,学生始终处于一条可识别的解答路径上。在这种情形下,模型可以预测编写程序时每一个相继目标(步骤)上正确动作的概率。例如,模型可以预测学生在编码函数 last-item 的六个目标中的每一个上执行正确动作的概率(见图 2)。模型在每一步的预测取决于该目标上适用编程规则的学生知识状况以及该规则的表现参数,如下式所示:
p(Cis) = p(Lrs) × (1 − p(Sr)) + (1 − p(Lrs)) × p(Gr)
也就是说,p(Cis),即学生 s 在目标 i 上执行正确动作的概率,是两个乘积之和:(1) 适用规则 r 对学生 s 而言处于已习得状态的概率,乘以规则处于已习得状态下正确作答的概率(p(Sr) 是图 4 中的失误参数);加上 (2) 适用规则 r 对学生 s 而言不处于已习得状态的概率,乘以规则不处于已习得状态下猜对的概率(p(Gr) 是图 4 中的猜测参数)。
为评估模型拟合导师数据的效度,我们在固定必修练习集的每个编码目标上计算两个指标:(1) 跨学生平均的实际正确作答概率;(2) 跨被试平均的模型预测正确作答概率。在计算这些指标时,我们逐一查阅导师协议文件(protocol files),其中完整记录了每个学生的反应。在固定必修练习集的每个编码目标上,我们先应用方程 2 预测学生正确应用适用规则的概率,再记录学生首次尝试是否正确作答,最后应用方程 1,依据反应证据更新”学生知道适用规则”的概率估计。
回顾一下,每个学生穿插在必修练习序列之间的补救练习各不相同。这些补救练习不计入实际准确率与预期准确率的指标,因为每个数据点只有部分学生贡献了数据。不过,补救练习被用来更新个别学生的知识状态。
我们用三个统计量来评估模型的预测效度。第一,把各目标上的实际准确率与预测准确率估计值求相关。如果模型既准确反映了每条编码规则的初始难度,又准确反映了每条规则在相继应用机会上的学习速率,这两个指标就应当高度相关。第二,计算各目标上的平均预测误差(预期准确率减实际准确率),以检查模型是否系统性地高估或低估准确率水平。最后,计算各目标上的平均绝对预测误差(“预测准确率减实际准确率”之绝对值的平均),以确定模型预测各目标之间准确率绝对差异的好坏程度。
4.2.1 实验 1:内部效度
最早的评估研究(Corbett & Anderson 1993)旨在检验规则集与参数估计的充分性。在该研究中,认知模型由 21 条理想编码规则组成,覆盖所引入的十来个 Lisp 构造。两个学习参数与两个表现参数的估计值在 21 条规则上保持恒定,这四个值由更早的一批学生估计得到。学生在该研究中完成 25 个必修练习,共 158 个编程目标;他们平均完成 14 个补救练习,范围从 1 到 38。如上所述,我们计算出 158 个必修编程目标各自的平均实际正确动作概率与预期正确动作概率,并跨目标比较这两个指标。预期概率与实际概率呈中等程度相关(r = 0.47,p < 0.05),平均误差率为 0.06,平均绝对误差率为 0.16。绝对误差率偏高,对数据的目视检查清楚表明,预测值与实际值以系统性的方式偏离观测值。这促使我们从两个方面修订知识追踪模型。
第一,显然,当学习与表现参数保持恒定时,模型对数据的拟合不佳。不出所料,有些规则比其他规则更难学;或许不那么显眼的是,失误与猜测的概率同样因规则而异。若允许学习与表现参数估计在规则之间变动,最优拟合估计能带来显著更好的拟合,r = 0.85;在修订后的拟合中,平均预测误差 −0.01 与绝对预测误差 0.07 均有所下降。
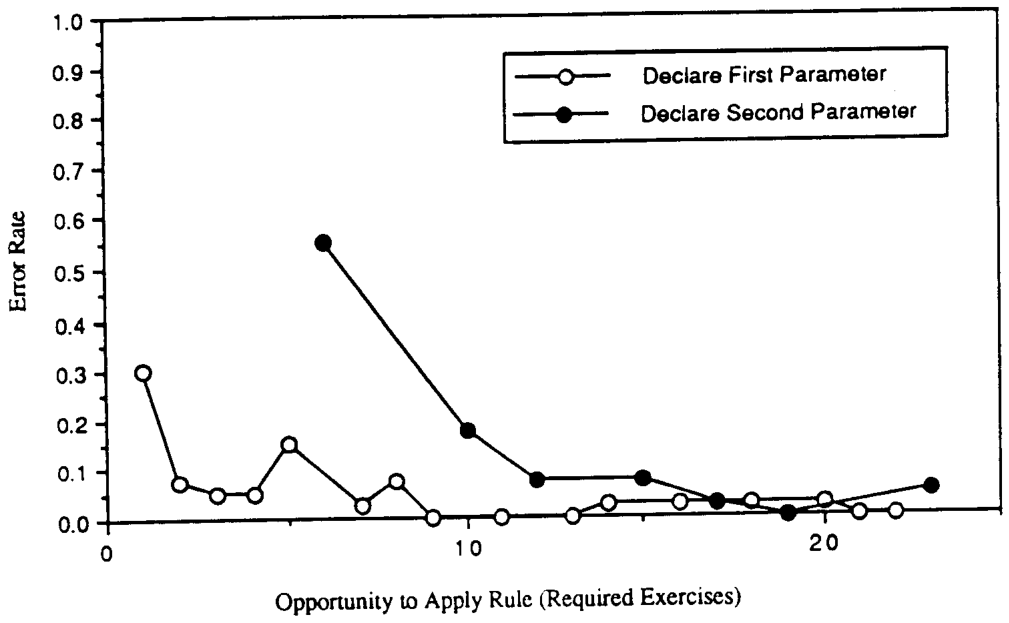
第二,显而易见,理想模型中的某些规则(至少对某些学生而言)过于宽泛,模型无法对其良好拟合。图 5 描绘了理想学生模型中如下规则的学习曲线:
在定义 Lisp 函数时,针对函数被调用时将传入的每一个参数(输入值),在参数表中声明一个参数变量。
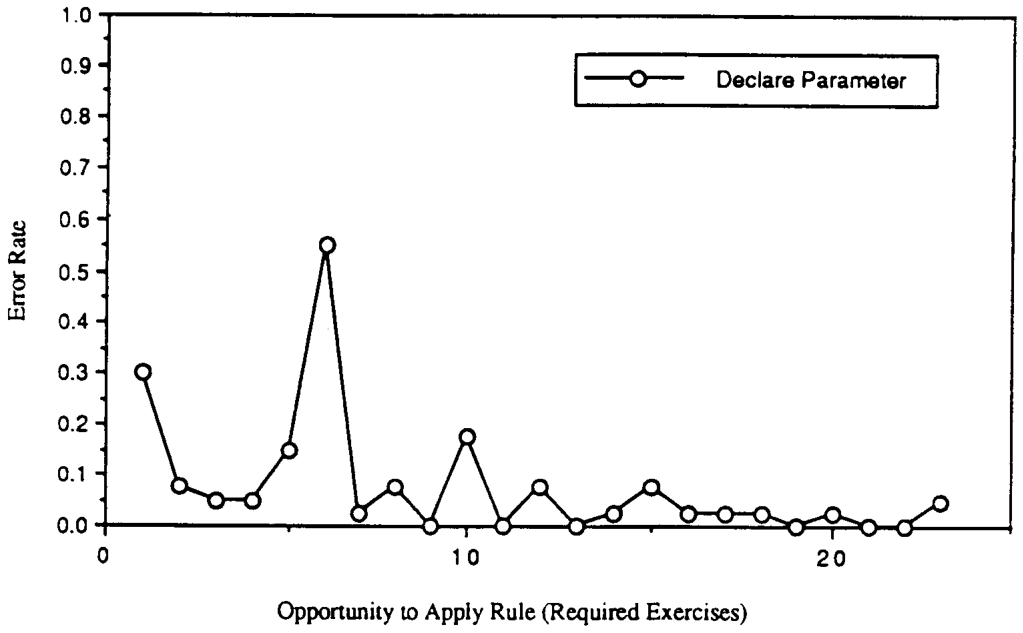
这条规则预期会在函数定义中每次声明变量时触发。由图可见,错误率在前四次应用中单调下降,但在第五、六次应用时跳升。前四个数据点来自最初四个定义函数的练习,这四个函数定义中各自只声明一个变量。第五、六个数据点代表第五个函数定义,但那是第一个声明两个参数变量的函数定义。第七、八个数据点代表另外两个只带一个参数的函数定义,第九、十个数据点代表下一个需要多个参数的练习。图中目标六处 55% 的错误率表明,最初编码出理想规则并能在新情境中应用它的学生略少于一半。其余学生最初编码的是一条非理想规则,它足以完成前四个练习,却无法推广。可能存在几种非理想规则:
总是编码一个变量来代表整个参数列表(过于宽泛)。
有一个参数时便编码一个变量(过于狭隘——没想过还会有更多参数)。
因为示例就是这样,所以编码一个变量(没有功能性理解)。
图 5|“在函数定义中声明变量”这一假设规则的学习曲线。绘制的是连续应用规则各机会上的错误率。
模型中的多种理想规则都观察到了类似模式。例如,一些学生在构建简单列表时能够应用构造函数 append、cons 和 list,却难以把自己的知识推广到嵌套列表。在代数等其他领域也观察到了类似困难(Wenger 1987),这显然对知识追踪构成严重威胁:学生可能因为在简单情境中掌握了某条”理想”规则而获得记分,而这条规则实际上并不能迁移到更复杂的情境。
我们针对这一问题修订了认知模型。最终,这门课程的认知模型增加到 55 条规则。就变量声明而言,我们把程序性知识表征为两条规则:
在定义 Lisp 函数时,为将要传入的第一个参数声明一个变量。
在定义 Lisp 函数时,为将要传入的每一个额外参数再声明一个变量。
图 6 重新绘制了声明变量的数据点。图 5 原始学习曲线中的数据点被绘制成这两条规则各自的学习曲线。在这种分析下,声明变量的第 6、10、12、15、17、19、23 次机会,实际上分别是应用第二条规则的第 1 至第 7 次机会。
图 6|把图 5 中变量声明的单一学习曲线拆分为两条不同变量声明规则各自的学习曲线。
4.3 外部效度:预测测验表现
更重要的问题是:模型能否预测学生在达到”掌握”之后独立工作时的表现。为评估这一预测效度,我们让学生在课程中的若干时点完成累积测验。在这些测验中,学生完成更多同类型的编程练习,界面与导师相同,但没有导师辅助。这些测验不用于决定何时让学生晋级,而专门用于验证模型的表现预测。我们的外部效度评估在两个方面不同于内部效度评估。第一,测量单位是完整的编程练习,而不是单个编程目标。预测学生在测验中每个编程目标上的表现,比预测他们在导师中逐目标的表现更为复杂,因为测验中学生不受”必须停留在成功解答路径上”的约束。不过,正如 ACT-R 那样假设产生式规则相互独立,我们仍然可以为每个测验练习整体推导出一个简明的准确率预测。无误完成一个练习的概率由下式给出:
∏p(Cis)
即学生在求解练习的每一个相继目标上正确作答概率的乘积。
第二,我们关心的是模型对学生之间个体差异(而非编程任务之间差异)的预测能力。为评估模型的外部效度,我们为每个学生计算其在一次测验中所有练习上的两个指标:(1) 正确完成练习的实际概率;(2) 正确完成练习的预测概率。我们再次计算三个统计量来比较这两个指标:(1) 跨学生的实际准确率与预期准确率的相关;(2) 跨学生的平均预测误差;(3) 跨学生的平均绝对预测误差。在模型准确捕捉个体差异的范围内,实际准确率与预测准确率应当在学生间高度相关,且跨学生的平均预测误差与平均绝对预测误差(预测与实际准确率之差的绝对值)应当较低。
4.3.1 实验 2:外部效度
本研究旨在检验模型对测验表现的预测效度。二十名大学生参加了第一项外部效度研究(Corbett, Anderson & O’Brien, in press)。他们在研究中学完六个课程节,并在第 1、4、6 节之后完成累积测验。课程被扩充为 64 个必修练习(共 345 个编程目标),以覆盖修订后的规则集。学生在前五个课程节中练习到掌握,第六节(最后一节)则不要求掌握。也就是说,在前五节中,学生完成一个由知识追踪过程支配的个别化补救练习序列;在最后一节中,学生完成一组固定的练习,没有补救。这使我们得以在前两次测验中检验学生达到掌握之后模型的有效性,并在第三次测验中检验模型在中间学习水平上的有效性。学生平均在前五节中完成 18 个补救练习,跨学生的范围从 3 到 63。测验练习使用与导师练习相同的界面完成,只是不提供辅导支持,并且学生可以自由编辑自己的代码。
第一步是验证修订后的认知模型与参数估计的内部效度。必修练习 345 个目标上预期与实际平均错误率的相关为 0.75,p < 0.0001;345 个目标上的平均预测误差为 0.01,绝对预测误差为 0.07。为了最大化模型的内部效度,我们为这批学生生成了最优拟合参数估计,并重新拟合导师数据。采用这些最优拟合估计时,实际与预期准确率值的相关为 0.90,平均误差为 0.003,平均绝对误差率为 0.04。我们用这些最优拟合参数估计来设定本研究中模型预测测验表现效度的上限。
回顾一下,正确完成一个测验练习的概率是成功满足每个目标的概率之乘积。为评估测验预测效度,我们计算了 (1) 每个学生正确完成练习的比例,以及 (2) 正确完成练习的平均预测概率。结果见表 I。
表 I|实验 2 三次测验中跨被试正确完成练习的实际比例与预期比例
| 测验 | 实际 | 预期 | MAE | rAE | rAR |
|---|---|---|---|---|---|
| 测验 1 | 0.89 | 0.90 | 0.09 | – | −0.25 |
| 测验 2 | 0.89 | 0.84 | 0.11 | – | −0.64 |
| 测验 3 | 0.55 | 0.64 | 0.18 | 0.69 | −0.68 |
注:实际、预期两列为正确完成练习比例的均值;MAE = 跨学生准确率预测的平均绝对误差;rAE = 跨学生实际准确率与预期准确率的相关;rAR = 跨学生必修导师练习错误率与测验准确率的相关。
第一列显示跨学生的平均实际准确率水平,第二列显示模型的平均预测准确率。可以看出,模型对这二十名学生的总体测验准确率预测相当准确。第三列显示这些预测跨学生的平均绝对误差。第四列 rAE 显示”编写正确程序的实际概率与预期概率”跨学生的相关。本研究前两次测验无法计算这一相关,因为模型对学生的个体差异完全不敏感。这两次测验位于第 1 和第 4 课程节之后,按照模型,学生此时已掌握全部规则。在这些节中,学生的知识估计没有变异,因而模型对测验表现的预测也没有变异。然而,第三次测验包含大量来自最后一个导师节的练习,学生在该节并未练到掌握。结果,学生在第三次测验上的绝对表现水平大幅降低,而且模型对学生知识状态的估计存在大得多的变异。在这些条件下,知识追踪模型对测验表现中的个体差异相当敏感。实际值与预期值的相关 r = 0.69 是显著的。(样本量为 19,因为一名学生的测验数据遗失。在本研究中,相关达到 0.46 或更高即在 0.05 水平上显著。)
虽然模型在第三次测验的中间学习水平上对学生表现的预测相当好,它对前两次测验的预测却值得怀疑。模型断言,这两次测验中所有学生处于同一学习状态,实际测验分数的任何变异都只反映随机噪声。这看上去难以置信,因为学生在进入研究时就存在可辨识的差异——这体现在不同学生完成的补救练习数量范围之大,从最少 3 个到最多 63 个。虽然补救理应缩小这些差异,但指望它彻底消除这些差异是极不可能的。为进一步考察这一问题,我们计算了一个学生入门特征的原始指标:学生在完成固定必修练习集时在导师中犯错的次数。我们把这一导师原始错误率指标与三次测验各自的实际测验准确率求相关。这些相关列于表 I 第 5 列(rAR)。
在每一种情形下,导师中的原始错误率与测验准确率之间都是负相关。总体而言,学生完成固定导师练习集时越吃力,他们在测验上的表现就越差,尽管导师已尽力补救。不过,第一次测验的相关 rAR = −0.25 并不显著,因此我们无法拒绝模型的主张,即这次测验上学生之间不存在真实差异。第三次测验的导师错误与测验准确率之间的显著相关 rAR = −0.68 同样不给模型带来麻烦:学生并未掌握第三次测验的全部课程,测验准确率自应反映导师难度,且模型对残余个体差异相当敏感,rAE = 0.69。然而,第二次测验的导师错误与测验准确率的相关 rAR = −0.64 却成了问题:虽然模型表明补救之后学生之间已无差异,导师错误率却是测验表现的一个强而显著的预测因子——在完成导师练习时挣扎的学生,在第二次测验上继续挣扎。
正如下一节所述,当模型没有表征学生在学习与表现上的个体差异时,就会出现这种结果模式。
4.4 学习与表现中的个体差异
前一项研究中的学习与表现参数估计因规则而异,从而反映了规则难度上的平均差异;它们并未反映学生在学习与表现上的个体差异。结果,只要学生在学习与表现上高于或低于平均水平,模型就会错估其学习状态。模型会低估高于平均水平学生的真实学习与表现参数,于是这些很少犯错的学生获得了超出所需的补救练习,测验表现也好于预期。相反,模型会高估那些犯错很多的低于平均水平学生的真实学习与表现参数;这些学生虽然比高水平学生获得更多补救练习,但获得的补救练习仍少于其所需,测验表现也差于预期。这就导致了观察到的导师错误与后测准确率之间的负相关。
为探讨这一问题,我们把学生之间的差异以个体差异权重(individual difference weights)的形式纳入模型。为每个学生估计四个权重,四种参数类型(p(L0)、p(T)、p(G)、p(S))各对应一个权重。虽然参数估计因规则而异,但对每个学生而言,每种参数只需一个调整权重就应足够,因为早先一项关于 Lisp 学习个体差异的研究并未发现学生个体差异与规则难度差异之间存在任何交互作用(Anderson, Conrad & Corbett 1989)。在修订后的模型中,每条规则的四个概率估计各被转换为比值(odds)形式(p/(1−p)),乘以相应的被试特定权重,再把所得的比值形式转换回概率。若令 i 表示参数类型(p(L0)、p(T)、p(G)、p(S)),r 表示规则,s 表示被试,则每条规则、每个被试的个体加权参数由下式给出:
pirs = pir × wis / (pir × wis + (1 − pir))
其中 pir 是跨所有学生对规则的最优拟合参数估计,wis 是该学生相应的个体差异权重。
我们最初用实验 2 的导师与测验数据检验了这一模型。我们假设每个学生的四个个体差异权重都不随时间变化,并在给定群体参数估计与学生导师表现数据的条件下,为每个学生推导出一组最优拟合权重。我们用这些权重为每个学生个别化每条规则的四个参数估计,然后在学生的导师数据上运行知识追踪程序,得到修订后的测验预测。所得测验预测见表 II。
表 II|个体差异:实验 2 三次测验中跨被试正确完成练习的实际与预期比例(基于最优拟合的个别化参数估计)
| 测验 | 实际 | 预期 | MAE | rAE | rAR |
|---|---|---|---|---|---|
| 测验 1 | 0.89 | 0.91 | 0.10 | −0.02 | −0.25 |
| 测验 2 | 0.89 | 0.86 | 0.10 | 0.51 | −0.64 |
| 测验 3 | 0.55 | 0.68 | 0.16 | 0.72 | −0.68 |
注:实际、预期两列为正确完成练习比例的均值;MAE = 跨学生准确率预测的平均绝对误差;rAE = 跨学生实际准确率与预期准确率的相关;rAR = 跨学生必修导师练习错误率与测验准确率的相关。
当然,第一列的实际测验表现没有变化,平均准确率预测也与先前分析相当接近。然而,这一个别化模型对第二次测验中的个体差异敏感得多:该测验的实际与预期准确率的相关现在达到显著,r = 0.51。
4.4.1 实验 3:个体差异的动态估计
个体差异的初步分析是有希望的,但所用的程序不适合在学生学习过程中进行动态决策,因为最优拟合权重是在学生完成学习之后才推导出来的。不过,该分析中每个学生最优拟合权重的对数,与该学生完成必修导师练习的原始错误率显著相关,这一关系可以用来在学生学习过程中动态估计个体差异。当学生在每个课程节开始时完成最基本的一组必修练习后,导师可以把学生的动作序列存储下来。然后,利用学生在这些必修练习上的错误率,通过回归方程估计一组学生特定的学习与表现权重,并导出加权参数估计。接着,对学生在必修练习上存储的动作进行知识追踪,估计其当前的知识状态。随后选择补救练习,知识追踪继续进行,直到学生掌握该课程节引入的每一条规则。
我们在两项研究中检验了这一估计程序。第一项见 Corbett, Anderson, Carver & Brancolini (1994)。该研究中,二十名学生完成了与前一项研究相同的课程,平均完成 11 个补救练习,范围从 0 到 98。因此,尽管补救练习的平均数量与前一研究相近,范围却更宽——这在参数估计被个别化时是意料之中的。该模型对导师数据拟合良好:必修练习 345 个目标上预期与实际平均错误率的相关为 0.79,p < 0.0001;345 个目标上的平均预测误差为 0.001,绝对预测误差为 0.06。表 III 列出了该研究的测验结果。可以看出,模型准确预测了第一次测验的总体表现水平,而对最后两次测验的表现高估了约 10%。最后两列分别报告实际测验表现与预测表现、以及与导师原始错误率的相关。第一次和第三次测验的结果与早先非个别化的知识追踪过程所得结果相当:在相对容易的第一次测验中没有个体差异的证据,而模型对第三次测验中低于掌握水平的表现所残余的个体差异非常敏感,r = 0.81(在本研究中相关达到 0.45 或更高即在 0.05 水平上显著)。第二次测验为修订后的个别化知识追踪模型提供了关键性检验。在本研究中,后测 2 的表现与原始错误率再次存在强相关,r = −0.63,可见尽管学生在名义上已练到掌握,真实的个体差异依然存在。然而与标准模型不同,个别化知识追踪模型对这些残余差异达到了中等程度的敏感,r = 0.31,p < 0.10。
表 III|个体差异的动态估计:实验 3 三次测验中跨被试正确完成练习的实际与预期比例(基于动态估计的个别化参数估计)
| 测验 | 实际 | 预期 | MAE | rAE | rAR |
|---|---|---|---|---|---|
| 测验 1 | 0.92 | 0.91 | 0.12 | −0.02 | 0.05 |
| 测验 2 | 0.76 | 0.87 | 0.15 | 0.31 | −0.63 |
| 测验 3 | 0.66 | 0.75 | 0.15 | 0.81 | −0.78 |
注:实际、预期两列为正确完成练习比例的均值;MAE = 跨学生准确率预测的平均绝对误差;rAE = 跨学生实际准确率与预期准确率的相关;rAR = 跨学生必修导师练习错误率与测验准确率的相关。
模型对第二次测验个体差异的敏感性,主要取决于学生之间表现上的估计差异,而非知识状态的差异。既然所有学生都为这次测验练到了掌握,给定学生学会每条规则的概率便介于 0.95 到 1.00 之间;这些概率的微小差异对准确率预测影响甚微。相反,准确率预测强烈关联于学生之间失误参数估计的差异,也就是说,关联于”当适用规则处于已习得状态时学生犯错的概率”上的持续差异。失误参数的性质将在下文更充分地讨论。
4.4.2 实验 4:知识追踪的当前评估
我们最近完成了对这一个别化知识追踪过程的第二次评估。本研究的课程被扩展到包括一节更复杂的构造/提取算法,必修练习总数则从 64 个减至 38 个。还新编了一个测验,紧随新的课程节之后。二十五名学生完成了这门课程直到掌握。个别化参数同样在学习过程中进行估计(依据的数据量约为前一研究的一半),学生平均完成 29 个补救练习。模型的预测再次良好拟合导师数据:必修练习 214 个目标上预期与实际平均错误率的相关为 0.71,p < 0.0001;345 个目标上的平均预测误差为 0.001,绝对预测误差为 0.06。
测验表现见表 IV。注意,在本表中,学生在全部三次测验之前都在完整课程上练到掌握,而不只是像先前研究中那样仅限前两次测验。总体而言,结果模式与前一研究相似。表的前两列同样显示平均实际准确率与预测准确率,实际准确率比预测低 5%–10%。最后两列显示实际测验准确率与预测准确率、以及与导师原始错误率的相关。第一次测验中没有明显的个体差异;实际与预期准确率跨学生的相关在第二次测验上边际显著(r = 0.36,p < 0.10),在第三次测验上显著(r = 0.66,p < 0.01)。
表 IV|知识追踪的当前评估:实验 4 三次测验中跨被试正确完成练习的实际与预期比例(基于动态估计的个别化参数估计)
| 测验 | 实际 | 预期 | MAE | rAE | rAR |
|---|---|---|---|---|---|
| 测验 1 | 0.88 | 0.94 | 0.11 | 0.24 | −0.28 |
| 测验 2 | 0.81 | 0.89 | 0.11 | 0.36 | −0.52 |
| 测验 3 | 0.81 | 0.86 | 0.10 | 0.66 | −0.73 |
注:实际、预期两列为正确完成练习比例的均值;MAE = 跨学生准确率预测的平均绝对误差;rAE = 跨学生实际准确率与预期准确率的相关;rAR = 跨学生必修导师练习错误率与测验准确率的相关。
图 7|实验 4 第三次测验的实际准确率对预期准确率作图(二十五名学生)。
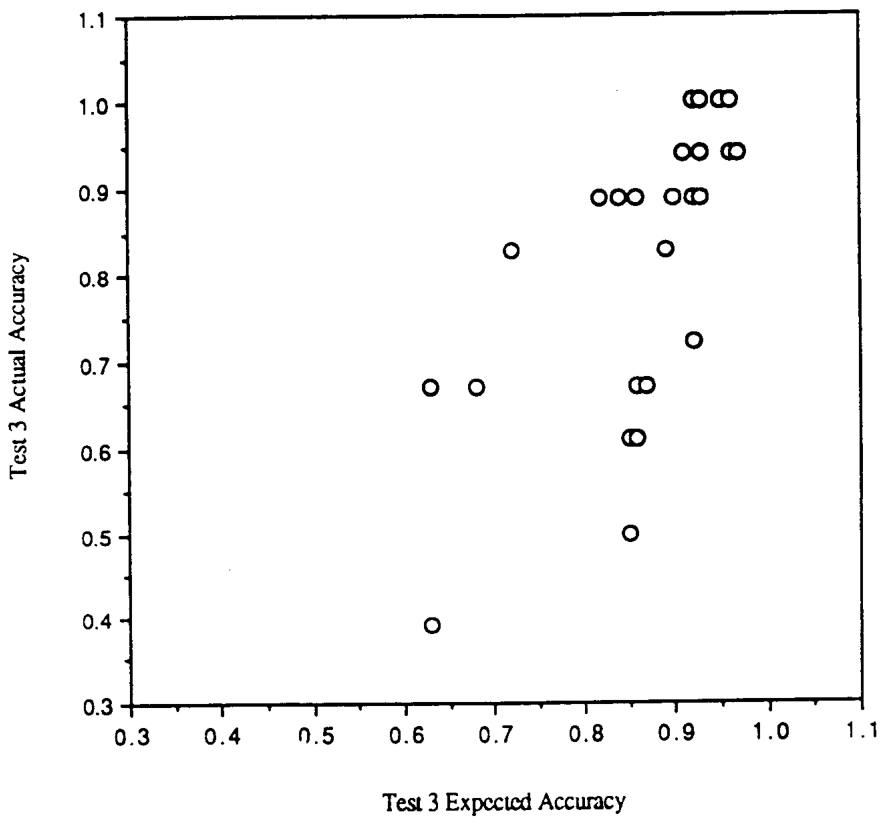
图 7 展示了二十五名学生在第三次测验上预期与实际测验准确率的相关。除了拟合质量之外,我们还可以问:就学生的实际测验表现而言,模型在帮助学生掌握课程方面有多成功。如果我们采用一个严格的掌握操作性定义——测验正确率达到 90%——图 7 表明,这一知识追踪条件下的学生有 56% 达到了掌握表现水平。本研究中另一组 21 名学生只完成了 38 个必修练习,可作对照:这些学生中只有 24% 达到了这一高水平的测验表现。两组之间成功概率的这一差异显著,z = 2.21,p < 0.05。知识追踪条件下的学生平均完成 29 个补救练习,因此他们比对照组多完成约 76% 的导师练习。不过,鉴于导师能把练习速度提高至多三倍,知识追踪导师条件下完成练习的总时间,与学生自行完成固定练习集所需的总时间相比,仍会处于非常有利的地位。
5. 未来方向
关于图 7 有一个有趣的观察:虽然模型估计所有学生基本上都已学会底层编程规则,它却预测一些学生会在测验题上犯将近 40% 的错误。如前所述,模型的掌握判断基于对学生知识状态的推断,而测验表现的预测既取决于学生对规则的知识,也取决于表现参数。当学生在导师中练到掌握之后,模型预测的变异主要取决于其中一个表现参数——失误参数。
如果我们只从学生的知识状态出发预测表现而不考虑表现因素,即采用方程 p(Cis) = p(Lrs),就能看出失误参数在测验预测中的重要性。按照模型,给定学生学会每条规则的概率介于 0.95 到 1.00 之间。如果测验预测仅依据这些知识概率而不考虑表现参数,模型会大大高估平均准确率:这一模型下第三次测验的预测准确率为 0.99,而平均实际准确率为 0.86。注意,在预测中纳入猜测表现参数(适用规则未知时正确作答的概率)会抬高预测准确率水平;然而实际上,猜测参数对测验预测几乎没有影响,因为每条规则的已习得概率估计都非常接近 1.0。相反,模型对测验表现预测的变异,主要反映了学生之间失误参数上的持续差异。这可以从 ln(失误权重) 与测验准确率跨学生的相关中看出,r = −0.72。
对失误有几种解释。一种解释是,失误权重的个体差异反映纯粹的表现效应,即学生在执行任务时的认真程度存在持续差异。这一解释意味着,“操作性”掌握所能达到的程度可能存在上限,即能达到严格测验表现标准的学生比例存在上限。它当然也意味着,额外的收益可以通过操纵学生在测验中认真作答的动机来获得,而不是通过额外的学习。不过,鉴于知识追踪的学习与表现假设相当简单,失误参数上的个体差异实际上也可能反映学习状态的差异。一种合理解释是:失误参数反映底层产生式规则强度上的差异。ACT-R 模型假设每条规则都有一个强度(strength)属性,强度随练习而变化,并影响规则触发的速度与可靠性。强度并未直接体现在简单知识追踪模型的学习与表现假设中,但会体现在失误参数中。考虑前述参数声明规则:较早形成理想规则的学生,将有机会在每一次函数定义练习中应用该规则;而最初形成次优规则的学生,最终必须至少再形成一条规则来替换或补充初始规则,由此得到的规则获得的练习会较少。这一解释表明,即使学生已达到标准学习状态,提供更多练习仍可改善测验表现。这样的框架可以这样实现:允许每个学生的失误权重随练习而变化,并持续练习直至其降到足够低的值。
另一种可能是,失误参数反映学生所形成规则的内容。也就是说,形成了与理想规则高度相关的某条规则(或规则集)的学生,会显得知道理想规则,但似乎不时失误。按照这一解释,一旦知识概率估计达到 0.95 的掌握标准,额外练习是否会对测验表现产生显著影响就没有保证。这表明有必要更密切地监控学生规则的内容。按照这一解释,在练习之前直接评估并补救学生对关键陈述性概念的掌握,可能比在练习中设法区分各种可能的规则表述更具成本效益。
6. 结论
我们是从一个可执行的 Lisp 编程技能认知模型起步开展这项研究的。该模型由一组理想产生式规则组成,构成了一个成功的智能编程导师的核心。研究的目标是实现一个简单的学生建模过程,使导师能够监控学生的知识状态,并按照学生的需要量身安排练习序列。所得到的知识追踪过程把学生建模为产生式规则的一个覆盖层,而基于掌握的课程结构使我们能把每个编程动作与单条产生式规则关联起来。一个简单的两状态学习模型使我们能够从表现估计学生的知识状态,并从这一知识状态预测表现。相继的评估促使我们:(1) 放弃最初的理想学生模型,转而建模一组充分的规则;(2) 为规则难度差异建模;(3) 为学生之间学习和表现的个体差异建模。最终的模型能相当好地预测学生表现,并使大多数学生达到高水平的任务表现。通过操纵测验中的动机、提供额外的程序性练习,或者监控并补救学生对关键陈述性概念的掌握,或许还能更上一层楼,让更多学生达到掌握。
致谢
本研究得到海军研究办公室(Office of Naval Research)N00014-91-J-1597 号资助。我们感谢 Valerie Carver、Scott Brancolini、Alison O’Brien、Chris Taylor 和 Holly Trask 在数据收集与分析方面提供的协助。
References
(参考文献共 26 条(扫描件可见部分),此处从略。)
译注: 1. 全文公式 (1)–(4) 均已对照原扫描件逐页核转写;原书乘号作 “*”,译文统一转写为 LaTeX 乘号。 2. 原扫描件第 259 页第 3 点 OCR 严重乱码(“SA vari. of results suor he assumption that orced descried dee is”),已据原图核正为 “A variety of results support the assumption that procedural knowledge is goal-specific”(多种结果支持程序性知识具有目标特定性这一假设)。 3. 第 275 页方程 p(Cis) = p(Lrs) 依原图转写(OCR 误作 “p(Lps)”)。 4. 第 273 页(4.4.2 节,实验 4)原文前句称必修练习共 214 个目标,紧接着一句仍写作 “across the 345 goals”,应为原文沿袭前文之误(原书如此),译文照录为 345。 5. 第 269 页 “the tutor number of errors each student made” 原文如此(疑为 “the number of errors” 之笔误),译作”学生在导师(练习)中犯错的次数”。同页 “The correlation of actual and expected valued, r = 0.69” 与 “test accuracy would be expected reflect tutor difficulty” 疑有排版脱漏(应分别为 values、expected to reflect),译文按文意处理。 6. 图 1 说明中的编辑节点记号,OCR 作 “<exprl>”,经放大原图核对为斜体数字 1,即 “<expr1>”。 7. 扫描件最后一页(原刊第 278 页)为空白页,参考文献列表在 Newell (1990) 条目后被截断;正文引用而参考文献列表缺失的条目包括 Pennington & Nicolich (1991)、Reed, Dempster & Ettinger (1985)、Resnick (1977)、Resnick & Resnick (1992)、Self (1988)、Shepard (1991)、Singley (1986)、Singley & Anderson (1989)、Slavin (1987)、Wenger (1987) 等。故”共 26 条”仅指扫描件可见部分。 8. 正文引作 Hyman & Cohen 1979,参考文献列表作 1970,原书如此,译文照录。 9. 图 1、图 3、图 5、图 6、图 7 为扫描图版,仅译出图注;图 2 与图 4 的实质内容(六条产生式规则、四个参数的定义)已转写为表格。表 I–IV 各列符号(MAE、rAE、rAR)依原图脚注转写。 10. 期刊首页标注出版年为 1995(1994 年 12 月 1 日收稿,1995 年 3 月 13 日定稿);文件名中的”1994”指收稿年份。