 囫囵
应用认知任务分析(ACTA):理解认知任务需求的实践者工具箱
Applied cognitive task analysis (ACTA): a practitioner’s toolkit for understanding cognitive task demands|Laura G. Militello, Robert J. B. Hutton(Klein Associates Inc., 582 E. Dayton-Yellow Springs Road, Fairborn, Ohio 45424, USA)|Ergonomics, 1998, Vol. 41, No. 11, pp. 1618–1641
关键词:认知任务分析;知识引出;知识表征;专长;效度;信度。
摘要:认知任务分析(cognitive task analysis,CTA)是一套用于识别熟练完成某项任务所需的认知技能(即心理需求)的方法。任务分析的成果可用于为界面与训练系统的设计提供依据。然而,CTA 需要大量资源,以往对设计实践者的用处有限。本文提出一种精简化的 CTA 方法——应用认知任务分析(Applied Cognitive Task Analysis,ACTA)。ACTA 由三种访谈方法构成,可帮助实践者提取关于某项任务所需的认知需求与技能的信息。ACTA 还能让实践者以更容易直接转化为应用成果(例如改进的训练情境或界面建议)的格式来表征这些信息。本文将描述这三种方法、一项为评估这些方法的可用性与实用性而开展的评估研究,以及使认知任务分析为实践者所用的若干未来研究方向。研究结果显示,ACTA 技术易于使用、灵活,并能提供清晰的产出。基于 ACTA 访谈形成的信息与训练材料被证明是准确的,且对训练十分重要。
1. 引言
在过去 100 年里,任务分析(task analysis)技术对训练与系统设计的发展起到了关键作用,其开端可以追溯到 Taylor(1911)和 Gilbreth 夫妇(Gilbreth 1911, Gilbreth and Gilbreth 1919)的开创性工作。(关于任务分析技术较新的综述,参见 Drury et al. 1987, Kirwan and Ainsworth 1992。)随着任务分析技术日益精细,开始同时关注认知活动与外显行为,它们却变得越来越不易为实践者所掌握。本文介绍应用认知任务分析(Applied Cognitive Task Analysis,ACTA),这是一套精简化的认知任务分析工具,专门为那些虽未接受过认知心理学训练、但其工作确实能从认知任务分析中获益的专业人员开发。
认知任务分析方法致力于描述和表征目标生成、决策、判断等行为背后的认知要素。认知任务分析往往以基于观察或初步访谈的任务高层描述为起点,但主要的数据收集工作是通过与领域专家(subject matter expert,SME)的深入访谈完成的。这类访谈着眼于获取完成任务所用认知策略的信息,包括态势评估策略、关键线索的识别与解读、元认知策略、重要的知觉辨别等。这些方法的一个优点在于,它们能帮助专家表达出通常难以言明的知识。尽管研究者常常被提醒要谨慎依赖口头协议数据(Nisbett and Wilson 1977),但也可以说,口头报告本质上并不比任何其他方法更多或更少地存在问题(Howard 1994, Spector 1994)。
将绩效的认知要素纳入训练与系统设计的紧迫性,源于工作场所性质的变化以及技术对许多任务和职能的影响。如今的工作任务对劳动者的认知技能提出了远高于以往的要求。Howell and Cooke(1989)指出,随着技术与机器职责的进步,我们加而非降低了人类的认知需求。更多程序性或可预测的任务由智能机器处理,而人类则要负责那些需要推理、诊断、判断和决策的任务。例如,在制造技术领域,关键技能如今包括用于监控设备的知觉技能、用于解读计算机化信息的诊断技能,以及在分布式决策环境中解决问题与协同配合所需的沟通技能。这些技能通常植根于对任务的一线实践经验,是熟练操作者最难提取或言明的技能之一。技术也有可能简化低层次工作;然而,许多人共同的担忧是,它使高层次工作变得更加复杂。
尽管过去 10 年间已开发并应用了多种强有力的认知任务分析方法,但很少有方法能为训练实践者和设计系统的工程群体所用。这些方法已在若干文献中有所描述(Klein 1993, Cooke 1994, Seamster et al. 1997)。例如,在一项历时多年的工作中,Hall et al.(1994)使用前置条件-行动-结果-解释(Precursor, Action, Result, and Interpretation,PARI)方法开发了一个航空电子设备故障排除训练器。Roth et al.(1991)使用认知环境模拟来研究核电厂操作员在故障管理中涉及的认知活动。Seamster et al.(1993)报告开展了一次大规模的认知任务分析,为美国联邦航空管理局的航路空中交通管制课程确定了教学内容与顺序。Rasmussen(1986)对核电厂控制室运行进行了透彻的认知分析。Rouse(1984)使用类似方法为军中的故障排除任务提炼出问题解决策略。
尽管这些成功案例非常有说服力地展示了认知任务分析的力量,但它们都需要相当多的时间和资源,都是科学家所开展研究工作的一部分,而非实践者开发应用的产物。作者的目标是推动 CTA 技术从研究界向作业界转化。基于已有的 CTA 技术,作者开发了一套精简化的 CTA 方法,供教学设计者和系统设计者(而非知识工程师、认知心理学家和人因工效学专业人群)使用。本文描述应用认知任务分析(ACTA)——为训练实践者和系统设计者开发的一套精简 CTA 方法,用于引出并表征熟练任务绩效的认知成分,并将这些数据转化为设计建议。
2. 应用认知任务分析
ACTA 技术是海军人事研究与发展中心(Navy Personnel Research and Development Center)资助的一个为期两年项目的成果。该项目旨在开发并评估能让教学设计者和系统设计者从领域专家那里引出关键认知要素的技术。本文介绍的各项技术互为补充,各自针对认知技能的不同侧面。第一种技术是任务图访谈,它为访谈者提供任务的整体概貌,并标示出任务中认知上困难的环节,以便在随后的深入访谈中进一步探究。第二种技术是知识审计,它考察完成特定任务或子任务所需的专长的各个方面;专长的每一个方面一旦被揭示出来,就会就其在实际工作情境中的具体例子、所使用的线索与策略、以及它为何对经验不足者构成挑战等进行追问。第三种技术是模拟访谈,它使访谈者能在特定情境的背景下探究领域专家的认知过程。使用模拟或情境能够提供其他访谈技术难以获得的工作情境脉络,因而可以围绕态势评估、态势评估如何影响行动方案、以及新手在同样情形下可能犯哪些潜在错误等议题做进一步的探究。最后,本文还提供了认知需求表,作为整合与综合数据的一种手段,使数据能够直接应用于具体项目。各项技术将在以下章节中详细介绍。
2.1. 任务图
任务图(task diagram)引出任务的整体概貌并识别困难的认知要素。虽然这一初步访谈只提供任务认知要素的表层视图,但它使访谈者能够聚焦更深入的访谈(即知识审计和模拟访谈),从而把时间和资源用在剖析那些最困难、最相关的认知要素上。
访谈时会请领域专家把任务分解为若干步骤或子任务,提问方式如:“想一想你(做感兴趣的任务)时要做些什么。你能把这个任务分解成少于六步、但多于三步的步骤吗?”其目的是让专家在头脑中走一遍任务,同时说出主要步骤。访谈者把领域专家限制在三到六个步骤之间,以确保时间不会浪费在表层访谈中对细枝末节的深挖上。在任务的各个步骤被表述出来之后,再请领域专家指出哪些步骤需要认知技能,提问方式如:“在你刚才确定的步骤中,哪些需要困难的认知技能?我所说的认知技能,指的是判断、评估、解决问题之类的思维技能。”由此得到的图(图 1)可作为后续访谈的路线图,它概览了任务所涉及的主要步骤、执行这些步骤的先后顺序,以及哪些步骤最需要认知技能。
图 1|任务图示例
火场指挥(Fireground Command):初始评估(Initial Assessment)→ 主要搜寻与救援(Primary search and rescue)→ 次要搜寻与救援(Secondary search and rescue)→ 讲评与总结(Critique/debrief)
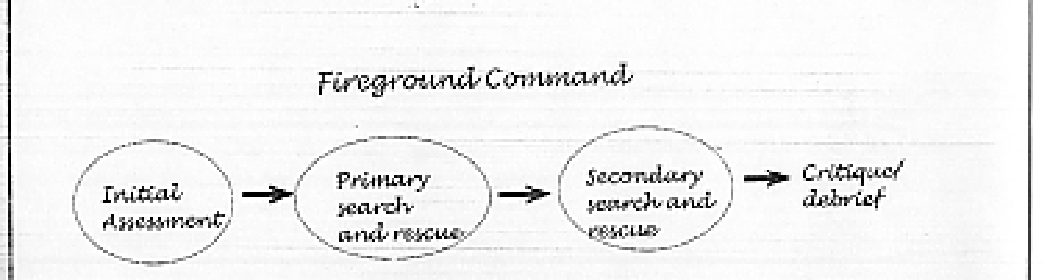
任务图访谈旨在对任务做表面层次的考察,并不试图解析每位领域专家的心智模型。其目标是引出对任务非常宽泛的概貌。正如 Rouse and Morris(1986)所指出的,试图刻画心智模型的努力会迅速退化为对一个人头脑中所有东西的大搜罗。在这一访谈中,作者建议把领域专家限定在六个步骤以内,并提醒访谈者不要陷入细节层面——那是其他访谈技术最适合捕捉的内容。
2.2. 知识审计
知识审计(knowledge audit)识别专长在某一领域中发挥作用的方式,并提供基于实际经验的例子。知识审计直接取材于关于专家—新手差异的研究文献(Dreyfus 1972, Chi et al. 1981, Shanteau 1985, Dreyfus and Dreyfus 1986, Hoffman 1992, Klein and Hoffman 1993),以及关于专家决策的关键决策法(critical decision method)研究(Klein et al. 1989, Crandall and Getchell-Reiter 1993, Klinger and Gomes 1993, Militello and Lim 1995, Kaempf et al. 1996)。开发知识审计,是为了在保住专长研究中最重要方面的同时,精简那些作为专长研究典型特征的密集型数据收集与分析方法。
知识审计围绕已被发现可以刻画专长特征的知识类别来组织。这些类别包括:诊断与预测、态势感知、知觉技能、开发并懂得何时运用行业诀窍、即兴发挥、元认知、识别异常,以及弥补设备局限。显然,作者本可以纳入更多条目,但我们的意图是保留数量最少而影响最大的成分。
知识审计采用一组探针(probes),用以描述各类领域知识或技能并引出恰当的例子(图 2)。其目的不仅是弄清每种成分是否存在于任务之中,更是要弄清这些技能的性质、需要运用这些技能的具体事件、已经使用过的策略,等等。这份探针清单是开展这一访谈的起点。随后,访谈者会就例子中的细节追问关键线索与决策策略。接着再讨论新手或经验较浅者在同样情形下可能犯的潜在错误。
图 2|知识审计探针
基本探针(BASIC PROBES):
- 过去与未来(Past & Future)。专家能够弄清一个态势是如何发展而来的,并能思考未来、预见态势的走向。除此之外,这还能让专家在问题形成之前就将其化解。 有没有过这样的时刻:你走进一个态势的中间,却清楚地知道事情是如何发展到这一步的、以及它们正朝什么方向走去?
- 大局观(Big Picture)。新手可能只看到零星的碎片。专家能够迅速建立起对整个态势的理解——即”大局观”视角。这使专家能够思考不同要素如何相互配合、相互影响。 你能举一个例子,说明对这个任务而言大局观的哪些方面是重要的吗?你必须了解并随时把握哪些主要要素?
- 察觉(Noticing)。专家能够觉察线索、看出经验较浅的人员可能完全忽略的有意义的模式。 你有没有过这样的经历:态势的某一部分突然”跳”到你眼前;你注意到正在发生而别人可能错过的事情?能举个例子吗?
- 工作诀窍(Job Smarts)。专家学会如何把各种程序组合起来,以尽可能高效的方式执行任务。他们并不偷工减料,但也不浪费时间与资源。 做这项任务时,有没有更聪明地干活或以更少投入完成更多事情的办法——也就是你发现特别管用的办法?
- 机会/即兴发挥(Opportunities/Improvising)。专家乐于即兴发挥——判断在这一特定态势中什么行得通;他们能够转换方向以利用机会。 你能想出一个例子,说明你在这个任务中曾经即兴发挥,或注意到可以把事情做得更好的机会吗?
- 自我监控(Self Monitoring)。专家了解自己的绩效表现;他们会检查自己做得如何并做出调整。专家会留意自己的绩效何时不符合应有的水平(这可能源于压力、疲劳、高工作负荷等),并能加以调整以保证工作完成。 你能否想起某一次,你意识到需要改变自己正在采用的作业方式才能完成工作?
可选探针(OPTIONAL PROBES):
- 异常(Anomalies)。新手不知道什么是”正常”,因此难以识别”异常”。专家能迅速发现不寻常的事件并察觉偏差。而且,他们能注意到该发生的事情没有发生。 你能描述一次这样的经历吗:你发现了偏离常规的情况,或者察觉有什么不对劲?
- 设备局限(Equipment Difficulties)。设备有时会误导人。新手通常设备说什么就信什么;他们不知道什么时候该持怀疑态度。 有没有过这样的情况:设备指向一个方向,而你自己的判断却让你去做别的事情?或者你必须依靠经验才能避免被设备引入歧途?
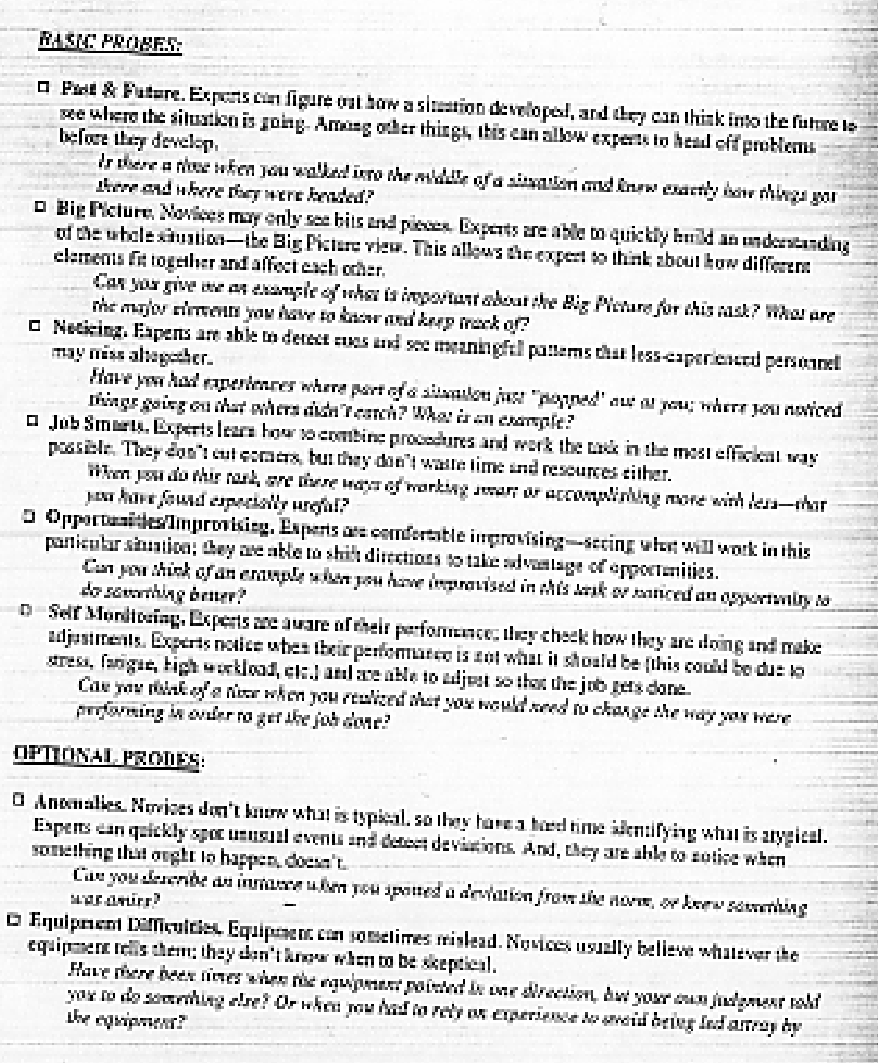
(原文图 2 中各探针下的问题以斜体排印。)
知识审计的产出如表 1 所示,它是一份特定任务专长的清单。该表包括经验发挥作用的情境实例、应对这些困难情境时所使用的线索与策略,以及对这类情境为何对经验较浅的操作者构成挑战的解释。
表 1|知识审计表示例
专长的各个方面 线索与策略 为什么困难? 过去与未来。例如:办公区一带发生爆炸;搜查各办公区而非爆炸源 危险化学品与爆炸区域方面的信息可查阅材料安全数据表(MSDS)。从最可能找到被困人员的位置开始,并顾及自身安全 新手受到的训练往往是从源头开始向外排查。他们可能不会查阅 MSDS 来确定爆炸的潜在源头,也不会考虑人员最可能在哪里 大局观。大局包括危险源、被困人员可能的位置、进入/退出路线、其他危险 感官、与他人的沟通、楼宇业主、MSDS、建筑预案 新手会出现”隧道视野”,只盯住一件事,例如被困人员 察觉。被困人员的呼吸声 你和搭档都停下来,屏住呼吸倾听。倾听哭声、自言自语声、被困人员碰倒东西的声音 自身呼吸器中的呼吸噪声、火灾的噪声。不知道该留意哪些声音
2.3. 模拟访谈
模拟访谈(simulation interview)使访谈者能够在一个事件的背景中更好地理解领域专家的认知过程。在作业环境中,工作的要点通常就是以某种方式对环境施加作用。Klein(1993)与 Howell and Cooke(1989)都曾指出,围绕高后果、困难决策的相关信息加以识别和探索,可以为形成有效的训练与系统设计提供可靠的基础。基于模拟和事件的访谈已在许多领域得到成功运用(Flanagan 1954, Grover 1983, Clarke 1987, Diederich et al. 1987, Bell and Hardiman 1989, Cordingley 1989, Klein et al. 1989, Thordsen et al. 1992, Hall et al. 1994)。
模拟访谈的基础是向领域专家呈现一个具有挑战性的情境(scenario)。作者建议访谈者选用一个已有的情境来开展这一访谈。模拟和情境常常是为训练目的而存在的。可能有必要对情境加以调整或修改,以适应时间限制等现实约束。专门为访谈开发一个新的模拟并非轻而易举之事,很可能需要先做一次前导性 CTA,以收集呈现一个挑战性情境所需的基础信息。模拟可以采取纸笔练习的形式,或许借助地图或其他图示。在某些场合,也可能使用视频或计算机支持的模拟。令人意外的是,根据作者的经验,模拟的保真度并不是关键问题;关键是模拟呈现了一个具有挑战性的情境。
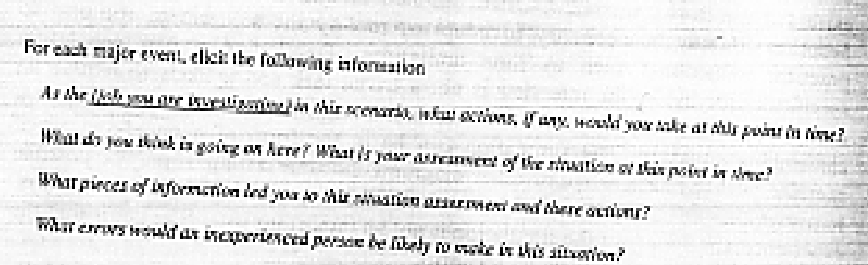
在接触模拟之后,请领域专家识别主要事件(包括判断与决策),提问方式如:“在体验这一模拟时,请设想你是该事件中的(所研究的职业)。稍后我会就你在此情境中会如何思考和行动提一系列问题。”对每一个事件,都围绕该事件就态势评估、行动、关键线索和潜在错误进行探询(图 3)。
图 3|模拟访谈探针
对每一个主要事件,引出以下信息:
- 作为该情境中的(所研究的职业),此时此刻你会采取哪些行动(如果需要采取行动的话)?
- 你认为这里正在发生什么?此时此刻你对态势的评估是什么?
- 是哪些信息促使你做出这一态势评估并采取这些行动?
- 经验不足的人在这种情形下容易犯哪些错误?
所引出的信息记录在模拟访谈表中(表 2)。对多位领域专家使用同一个模拟进行访谈,可以洞察那些不止一种行动都可接受、对同一态势的不同评估都言之成理的情形。这一技术可用于凸显领域专家之间观点的差异,而这些信息对于形成训练与系统设计建议十分重要。该技术还可用于对比专家与新手的视角,做法是让专长水平不同的人使用同一个模拟接受访谈。
表 2|模拟访谈表示例
事件 行动 评估 关键线索 潜在错误 抵达现场 清点人员(姓名);询问邻居(但不能听信其言,要亲自核实);队员逐户敲门确认确实无人 夜晚寒冷,需要为已疏散的人员找到安置之处 夜间时段;寒冷(15°);死角空间;加建楼层;劣质材料——木板(疏松朽板)、金属大梁(受火弯折断裂);整栋楼的阁楼相通 没有随时掌握人员动向(可能在寻找根本不在场的人) 初步进攻 留意建筑倒塌的迹象;若出现倒塌迹象,则撤离,并从建筑物外侧向其喷水 施工有缺陷,建筑可能倒塌 建筑倒塌的迹象包括:墙体的动静——开裂;楼板的动静——呻吟般作响;金属大梁的动静——咔嗒声、爆裂声;老建筑中的缆索维系着墙体 对阁楼进行通风,这会把火抽上去,并使其沿管道和电气系统蔓延
2.4. 认知需求表
在对多位领域专家开展 ACTA 访谈之后,作者建议使用认知需求表(cognitive demands table)(表 3)来梳理和分析数据。显然,访谈中讨论的信息并非每一条都与特定项目的目标相关。认知需求表为实践者提供了一种格式,用于把分析聚焦到项目目标上。作者根据以往开展的分析,提供了该表的示例性栏目标题(困难认知要素、为何困难、常见错误、所使用的线索与策略),但建议实践者把注意力放在自己开发新课程或设计新系统时所需的信息类型上。该表还能帮助实践者看出数据中的共同主题,以及多位领域专家所提供信息中的相互矛盾之处。
表 3|认知需求表示例
困难认知要素 为何困难? 常见错误 所使用的线索与策略 知道爆炸后应从何处搜起 新手可能没有接受过处置爆炸事件的训练。其他训练提示应当从源头开始向外排查。并非所有人都了解材料安全数据表(Material Safety Data Sheets),其中载有重要信息 新手很可能从爆炸源开始搜索。对大多数其他类型的事件而言,“从源头开始”是一条经验法则 从最可能找到被困人员的位置开始,同时牢记安全方面的考虑。查阅材料安全数据表以确定危险化学品可能位于何处。考虑建筑结构的类型以及被困人员可能所在的位置。考虑再次发生爆炸的可能性。时刻顾及班组人员的安全 在燃烧的建筑中寻找被困人员 存在大量干扰性噪声。如果你紧张或疲劳,自己的呼吸声会让你很难听到其他任何声音 新手有时识别不出自己的呼吸声,误以为那是被困人员的呼吸声 你和搭档都停下来,屏住呼吸倾听。倾听哭声、被困人员的自言自语声、被困人员碰倒物品的声音等
3. 评估研究
正如 Hoffman et al.(1998)所指出的,如何以实证方式检验知识库、以及用于表达和表征该知识库的方法论,这一问题很少受到研究界的关注。许多认知任务分析方法仅仅依据”它们对某一特定应用或项目是否似乎奏效”这类主观判断来评价。例外包括 Crandall 及其同事使用关键决策法对数据收集技能的效度与信度所做的评估(Taynor et al. 1987, Crandall and Calderwood 1989, Crandall and Gamblian 1991, Crandall and Getchell-Reiter 1993),以及 Hoffman 及其同事所做的方法比较(Hoffman 1987, Hoffman et al. 1995)。本节所描述的评估研究不仅试图针对这一特定的 CTA 技术组合解决效度与信度问题,还涉及在真实世界任务背景下评估效度与信度时所面临的诸多问题。
3.1. 方法
我们开展了一项针对 ACTA 技术的评估,以确立使用这些方法所收集数据的效度与信度,并评估这些技术的可用性。此外,还把使用 ACTA 技术收集的信息与使用非结构化访谈技术收集的数据进行了比较。本次评估在两个领域中并行开展。作者的意图是用一批”新手用户”——即缺乏认知任务分析或教学设计知识与经验的人——来检验 ACTA 技术。新手样本能够更干净地考察 ACTA 方法对所产出数据的类型与质量的影响。因此,研究者通过校园公告栏张贴和电子邮件,招募了临床心理学、人因学或认知心理学研究生课程的学生,在消防领域或电子战(Electronic Warfare,EW)领域开展访谈并制作教学材料。对志愿者进行了筛选,确保他们对其将要研究的领域没有既有知识,没有开展 CTA 的既往经验,也没有开发课程材料的丰富经验或相关训练。每名学生获得 250 美元的参与报酬。12 名学生在消防领域开展访谈,11 名学生在电子战领域开展访谈。接受访谈的领域专家包括:来自美国俄亥俄州代顿市代顿大区的资深火场指挥员(Fireground Commander),他们至少有 10 年经验,并由当地各消防部门的消防队长推荐;以及来自美国加利福尼亚州圣迭戈太平洋舰队训练中心(Fleet Training Center Pacific)的资深电子战技师,他们担任电子战技师至少 6 年,其中包括 4 年的海上服役经历,并拥有担任电子战监督员的经历。
在每个领域内,学生被分入两组。研究者尝试按年龄、性别和受教育程度对两组进行匹配。按这些标准完成匹配之后,再将学生随机分配到各组。所有学生都参加了一个 2 小时的工作坊,内容包括介绍认知任务分析的基本概念,讲解认知任务分析在教学材料开发中的应用,并简要概览他们将要研究的领域与具体任务。学生还接受了关于访谈后需开发哪些训练材料的指导。这些材料包括一份认知需求表、若干学习目标,以及对一本训练手册的修改。
在最初的 2 小时工作坊之后,相互匹配的两组学生在研究的剩余阶段分开。其中一组称为非结构化组(Unstructured group),得到的指导是:以他们自己认为对收集认知信息最有用的任何形式与领域专家开展访谈。他们被告知要花时间准备问题,但没有任何关于如何组织访谈或应提出哪类具体问题的指引。另一组称为 ACTA 组,参加了一个为期 6 小时的 ACTA 技术工作坊,内容涵盖知识引出与知识表征。
非结构化组和 ACTA 组的学生随后各与领域专家进行两次访谈。每名学生主持一次与某位领域专家的访谈,并观摩另一名学生与另一位领域专家的访谈,因此每人可获得来自两次访谈的数据。ACTA 组的每名学生主持一次 ACTA 访谈并观摩同领域的一次 ACTA 访谈;非结构化组的每名学生主持一次非结构化访谈并观摩一次同领域的非结构化访谈。没有哪位领域专家被访谈两次。消防领域的学生被要求聚焦于火情侦察评估(size-up)任务;电子战领域的学生被要求聚焦于信号威胁分析。所有访谈均安排 3 小时的时间段。
在完成两次访谈后的一周内,每名学生参加一个 4 小时的环节,用于分析数据并开发训练材料。学生被要求在预定环节之前不得开展协作,也不得对访谈笔记做任何额外加工。在这 4 小时中,他们需要对访谈获得的信息加以结构化并予以表征。研究者向他们提供了材料与指导,并要求: (1) 用认知需求表格式整合访谈数据; (2) 为该领域的一门假想课程开发至少十条认知学习目标; (3) 根据访谈所学,修改或补充训练手册(手册由研究者提供);以及 (4) 填写一份关于研究参与的问卷。 此外,所有接触过 ACTA 技术的学生还要填写一份 ACTA 可用性问卷。
3.2. 数据转换
为了生成关于实用性与效度的定量指标,需要对 ACTA 工具所产生的信息进行大量的数据编码与转换。研究生样本生成的所有材料,均由至今尚未参与本研究的领域专家和/或认知心理学家进行评定。只要有可能,数据评定都由多名编码者完成,以便评估评分者间信度。在某些情况下,由于人员难以请到或资源限制,只能请一位领域专家对数据进行编码。研究者设计了针对效度两个方面的测量:(1) ACTA 工具产出的信息是否以认知性内容为主;(2) 产出的信息是否具有领域特定性并切合相关。数据转换流程及相应测量将在以下章节中详细介绍。
3.2.1. 效度指标——认知需求表
认知需求表中的所有条目由 Klein Associates 的两名研究者 Laura Militello 和 Rebecca Pliske 博士进行编码,编码者对处理组别(ACTA 组与非结构化组)保持盲态,判断条目是否包含认知内容。划入认知需求类别的标准是:该条目涉及消防员/电子战操作员在工作中遇到的认知技能或认知挑战(例如”判断现场水源是否充足”、“设计成功将人员撤出燃烧建筑的策略”)。划入非认知需求类别的条目通常指消防员/电子战操作员应当具备的陈述性知识(例如”知道初始指挥序列”)或行为(例如”把器材放回原位”)。[尽管可以说知道正确的指挥序列也包含认知成分,但它并不构成一名胜任的火场指挥员所必需的认知挑战或技能,而是成为一名火场指挥员之前必须习得的一类背景知识。]
为了确定使用 ACTA 技术的学生能否跨相关认知类别(而非基于任务的类别)一致地引出信息,作者基于 Rasmussen 的决策模型(Rasmussen 1986, Rasmussen et al. 1994)开发了一套编码方案。类别包括信息收集、态势分析、诊断、预测、价值判断、选择、计划与调度。两名对学生的访谈组别(ACTA 组与非结构化组)保持盲态的评分者独立评定了 30% 的数据,两人达到了可接受的评分者间一致性(一致性百分比 = 74%)。[虽然可接受的评分者间一致性并无公认标准(Meister 1985, Pedhazur and Schmelkin 1991),但对于这类编码,超过 70% 的一致性通常被认为是足够的。研究者对数据子集持续分析,直到达到可接受的一致性水平,其余数据再由一名编码者分析。]其余数据随后在两名评分者之间分配,以完成全部评定。
认知需求表领域特定内容的评定基于数据库中的消防部分。研究者针对消防领域开发了一套基于任务的编码方案。根据美国国家消防学院(National Fire Academy,位于美国马里兰州埃米茨堡)向作者提供的消防手册可以确定,火场指挥员负责三项主要子任务:火情侦察评估(size-up)、战术与策略(strategy/tactics)、以及管理(management)。对于消防数据,编码者独立评定每条认知需求表条目的内容,并将其归入这三个类别之一。编码者在 40% 的数据上建立了信度(一致性百分比 = 81%),其余数据由一名研究者完成编码。
作者还认为,应当请领域专家对数据进行评定,以评估数据的质量与相关性。消防数据的评定由俄亥俄州消防学院事件指挥(Incident Command)课程的一名教官完成。他拥有 10 年以上的消防经验,担任过火场指挥员,目前参与俄亥俄州消防学院消防课程教学材料的开发。电子战领域专家是一名退役的美国海军电子战技师,拥有作为操作员、监督员和教官的丰富经验。研究者请领域专家指出:每份认知需求表所含信息中,有多大比例可能只有经验丰富的人员才知道。此外,还请领域专家指出每份认知需求表中有多大比例的信息,对经验丰富、技能娴熟的人员(火场指挥员/电子战监督员)是有用的,而不是对上岗不久、经验尚浅的人员(消防员/新任电子战操作员)有用。鉴于 ACTA 技术的目标之一是引出基于经验的知识(相对课堂知识而言——课堂知识很容易用其他传统技术获取并通过教科书传播),作者希望把”只有经验丰富者才知道的信息”与”刚结束训练的人就知道的信息”区分开来。这两个问题都旨在区分反映经验的知识与课堂知识。
3.2.2. 效度指标——教学材料
除上述消防领域专家外,研究者还招募了俄亥俄州消防学院的另一名教官,为消防领域学生生成的教学材料评分。他同样拥有 10 年以上的消防员经验,担任过火场指挥员,目前参与俄亥俄州消防学院课程材料的开发。此外,研究者还招募了美国佛罗里达州彭萨科拉电子战”A”学校(Electronic Warfare ‘A’ School)的两名电子战教官,为电子战领域研究生生成的教学材料评分。这两名电子战领域专家军衔均在 E-6 或以上,担任过电子战监督员,并有在电子战”A”学校任教的经历。
各领域的领域专家独立工作,对每一条学习目标和每一处训练手册修改评定其准确性、重要性,以及其内容当前是否已包含在典型的消防员训练/电子战教学大纲之中。效度评定采用 3 点量表:1 = 不重要,2 = 重要,3 = 非常重要。准确性评定采用 2 点量表:1 = 不准确,2 = 准确。在消防领域,准确性评定和重要性评定获得了可接受的评分者间一致性,但”学习目标所述信息当前是否已包含在典型的消防员训练课程中”这一评定未能获得可接受的一致性。[由于信度指标不可接受,未再对”信息当前是否已包含在课程中”的相关数据做进一步分析。与消防领域专家的讨论表明,他们教授的课程各不相同,因而对消防教学中通常包含哪些内容持有不同看法。]就学习目标而言,消防领域专家准确性判断的一致性百分比为 87.8%;重要性评定的一致性百分比为 71.4%。就学员手册修改而言,准确性的一致性百分比为 90.1%,重要性为 76.1%。在后续分析中,采用了在为火场指挥员开发训练材料方面经验更丰富的那位领域专家所做的准确性与重要性评定。
电子战领域的领域专家未能达到可接受的评分者间一致性。就学习目标而言,重要性的一致性百分比为 58.5%,准确性为 67.9%。就学员手册修改而言,重要性的一致性百分比为 34.2%,准确性为 61.7%。与领域专家的讨论表明,电子战岗位可能因所服役舰艇类型的不同而大相径庭。这两名专家曾在不同类型的舰艇上服役,目前教授的课程也截然不同(基础战术与装备入门课程)。因此,对于电子战操作员在学校应当学什么才能为上岗做好准备,两人持有相当不同的看法。在所有后续分析中,作者采用了海上经历最新、最丰富的那位领域专家的评定。
3.3. 结果
结果部分首先报告与 ACTA 技术的可用性、效度和信度有关的发现,因为这些是评估研究要回答的主要问题。因此,以下各节呈现的数据仅基于那些完成了 ACTA 工作坊并使用这些方法对领域专家进行了访谈的学生。结果部分的最后讨论 ACTA 访谈学生生成的材料与开展非结构化认知访谈的学生生成的材料之间的差异。虽然几乎未发现组间差异,本文也讨论了较大的组内变异对本研究的影响。
3.3.1. 可用性
在评估 ACTA 工具时,作者关注访谈者与受访者双方的主观体验。用户接受度是本项目成败的关键。为评估用户接受度,共实施了三份问卷:专门针对 ACTA 技术的可用性问卷、从领域专家视角获取信息的受访者问卷,以及反映参与研究全过程体验的访谈者问卷。问卷数据的发现如下。
3.3.1.1. 可用性问卷
所有使用 ACTA 技术的研究生都填写了可用性问卷。总体而言,评定非常积极,所有工具都被评为有用。一个兼顾领域(消防、电子战)、ACTA 技术(任务图、知识审计、模拟访谈)以及可用性问卷中各单个问题(问题 2、3、4、5)的 3 因素混合设计方差分析(ANOVA)显示,三种技术的可用性无差异,F(2, 18) = 1.34, p = 0.29;各技术在两个领域间的可用性亦无差异,F(1, 9), p<1。在 5 点量表上(“5”为最积极的评定,“1”为最消极的评定),所有维度的均值都高于”3”(表 4)。这些数据表明,研究生们认为: (1) 方法易于使用; (2) 访谈指南和工作辅助工具灵活; (3) 访谈产出清晰; (4) 知识表征有用。
表 4|使用 ACTA 技术开展访谈的研究生的可用性问卷均值
问题* 任务图
消防 (n = 6)任务图
电子战 (n = 5)知识审计
消防 (n = 6)知识审计
电子战 (n = 5)模拟访谈
消防 (n = 6)模拟访谈
电子战 (n = 5)ACTA 总体
消防 (n = 6)ACTA 总体
电子战 (n = 5)圈出你在使用该工具之前用于熟悉它的时间量† 1.00 (0.00) 1.40 (0.55) 1.17 (0.41) 1.40 (0.55) 1.00 (0.00) 1.20 (0.45) 不适用 不适用 评定你觉得该技术易于使用的程度 4.67 (0.52) 4.60 (0.89) 3.67 (1.03) 3.80 (1.30) 3.83 (1.60) 4.40 (0.89) 4.17 (0.75) 4.20 (0.45) 评定你觉得访谈指南灵活的程度 4.17 (0.75) 3.40 (0.55) 3.67 (1.03) 3.40 (0.55) 3.83 (1.17) 3.60 (1.14) 3.83 (1.21) 3.20 (0.45) 评定你觉得访谈产出清晰的程度 4.67 (0.52) 4.00 (1.00) 4.00 (1.10) 3.60 (0.55) 3.83 (1.83) 4.60 (0.55) 4.00 (1.10) 4.00 (0.00) 评定你觉得知识表征有用的程度 4.50 (0.55) 4.00 (0.71) 4.17 (1.17) 3.80 (0.84) 3.83 (1.21) 4.00 (0.71) 4.33 (1.21) 4.40 (0.55) *所有问题均采用 5 点评定量表,除非另有说明,5 为最积极的评定,1 为最消极的评定。括号内为标准差。 †关于每个工具所需准备时间的问题采用 3 点量表:1 = 1 小时及以下;2 = 1 至 2 小时;3 = 2 小时以上。
3.3.1.2. 受访者问卷
每位领域专家在访谈结束时都要填写一份简短问卷。如果 ACTA 工具要在一个作业群体中被接受,受访者的印象会产生相当大的影响。如果领域专家觉得访谈过程令人生厌,或者认为访谈没有给他们传达工作关键要素的机会,那么 ACTA 工具在一个组织内的接受度将大打折扣。
问卷数据表明,受访者认为访谈经历是愉快的、值得的。表 5 呈现了参与 ACTA 访谈的领域专家对每个问题的评定均值。一个兼顾领域(消防、电子战)、访谈类型(ACTA、非结构化)与问题(问卷中的 5 个问题)的 3 因素混合设计方差分析显示,受访者的反应不存在领域差异,F(1, 20) = 0.82, p<1。
表 5|接受 ACTA 技术访谈的领域专家的受访者问卷均值
问题* 消防 (n = 6) 电子战 (n = 5) 总均值 (n = 11) 总的来说,我觉得这次访谈是一次愉快的经历 4.33 (0.52) 3.60 (1.14) 3.97 (0.89) 访谈的形式让我得以展现自己的专长 4.50 (0.55) 3.60 (1.14) 4.05 (0.94) 我觉得访谈持续的时间太长了†(1 = 非常同意,5 = 非常不同意) 4.00 (0.63) 4.00 (0.71) 4.00 (0.63) 参与这次访谈让我对自己工作中的认知方面有了新的认识 3.67 (1.03) 3.20 (1.48) 3.44 (1.21) 我认为访谈中讨论的我工作中的那些认知方面,是新手应当学习的重要内容 4.33 (0.52) 4.00 (1.22) 4.17 (0.87) *所有问题均采用 5 点评定量表。除非另有说明,1 = 非常不同意,5 = 非常同意。括号内为标准差。 †问题 3 的量表作了反转,使高分代表更积极的反应,以与问卷中其他问题保持一致。
3.3.1.3. 访谈者问卷
所有研究生在完成评估研究的参与后都要填写一份问卷。该问卷由 10 个问题构成,旨在捕捉访谈者的主观体验,涉及信心水平、对认知任务分析过程难易度的感知等问题。ACTA 组每个问题的均值见表 6。
这些数据表明,两个领域的研究生都认为访谈提供了关于职业领域的认知信息,且信息量大。基于通过 ACTA 访谈学到的信息,研究生们认为填写认知需求表和生成学习目标并不困难。参与者表示,他们能够对所提供的课程材料做出重要修改。令人意外的是,参与者对”我还想进行更多访谈,因为我仍然想要更多信息”这一陈述反应消极。作者对此唯一的解释是:由于参与者是认知任务分析的新手,他们没有预料到通过这些技术所能获得的知识广度与深度。
表 6|使用 ACTA 技术开展访谈的研究生的访谈者问卷均值
问题* 消防 (n = 6) 电子战 (n = 5) 总均值 (n = 11) 我对自己主持访谈的能力有信心 4.33 (0.82) 4.00 (0.00) 4.17 (0.60) 与我主持的访谈相比,我从观摩的访谈中学到了更多信息 2.00 (0.89) 3.00 (1.23) 2.50 (1.13) 我觉得我已拥有修改课程材料所需的信息 4.00 (0.89) 3.20 (1.30) 3.60 (1.12) 访谈为我提供了关于该职业领域所涉认知技能的重要信息 4.33 (0.52) 3.60 (1.14) 3.97 (0.89) 我还想进行更多访谈,因为我仍然想要更多信息 2.33 (0.82) 3.20 (1.30) 2.77 (1.10) 认知需求表易于填写 4.00 (1.26) 3.40 (0.89) 3.70 (1.10) 基于认知需求表中给出的信息制定课程目标很容易 4.33 (0.52) 3.20 (1.64) 3.77 (1.25) 我能够运用这些信息对课程材料做出重要改动 3.50 (0.84) 3.40 (1.14) 3.45 (0.93) 总的来说,我觉得这些访谈信息量很大 4.83 (0.41) 4.60 (0.55) 4.72 (0.47) 就现有信息而言,我觉得修改课程材料是件简单直接的事 3.67 (0.82) 3.00 (1.23) 3.34 (1.03) *所有问题均采用 5 点评定量表。除非另有说明,1 = 非常不同意,5 = 非常同意。括号内为标准差。
3.3.2. 效度
表 7 呈现了针对效度三个核心问题的数据: (1) 所收集的信息是否涉及认知议题? (2) 所收集的信息处理的是否是基于经验的知识,而非课堂知识? (3) 生成的教学材料是否包含对新手学习重要且准确的信息?
ACTA 所引出信息在多大程度上属于认知性质,是通过逐一检查认知需求表中每一条目的认知内容来评定的。认知内容编码表明,生成条目中足有 93% 涉及认知议题。更具体地说,在消防研究中,92% 的条目被评为认知性条目;在电子战研究中,使用 ACTA 的学生生成的认知需求条目有 94% 被评为认知性条目。
为考察 ACTA 工具是否提供了引出基于经验知识的手段,研究者请领域专家对每份认知需求表做总体评估,并为其赋予一个百分比,以反映其中只有经验非常丰富的人才可能知道的信息所占的比例。这里的推断是:这类信息反映的是基于经验的知识,而非在课堂环境中轻易可以获得的知识。新受训人员拥有的信息更可能是在课堂环境中习得的,而非来自亲身经历。
研究结果有力地支持:ACTA 工具使学生得以引出重要且相关的领域信息。在消防研究中,认知需求表内容中被判定为”只有经验非常丰富的人员才会知道”的信息平均占 95%。在电子战领域,同样的评定在 ACTA 组的平均值为 90%。在信息相关性方面,认知需求表中相当高比例的信息(M = 73%)被评为与火场指挥员相关。电子战领域得到了类似的结果:认知需求表中的信息平均有 87% 被评为与电子战监督员相关。
第三个效度问题聚焦于 ACTA 用户生成的教学材料的重要性与准确性。测量指标包括领域专家给出的重要性评定与准确性评定。3 点重要性评定被合并为二分变量,“重要”与”较为重要”的评定合并为单一的重要性指标。准确性本身即按二分方式评定(准确/不准确)。结果表明,在两个领域中,ACTA 生成的教学材料内容都被视为新手应当学习的重要领域信息。在消防领域,每名学生生成的教学材料修改平均有 70%、学习目标平均有 95% 被评为重要。在电子战领域,这两个均值分别为 93% 和 83%(表 7)。
准确性评定同样较高,消防数据尤其如此。在消防领域,学员手册修改平均有 89% 被评为准确,学习目标平均有 92% 被评为准确。在电子战领域,这两个均值分别为 65%(学员手册修改)和 54%(学习目标)。作者怀疑电子战领域准确性评定偏低是缘于该领域更强的技术性。电子战操作员/监督员所处的工作环境对研究生而言过于陌生,理解并使用电子战操作员/监督员用来描述设备和环境的术语与缩略语带来了额外的困难。在不少案例中,为数据评分的电子战领域专家表示,他们知道学生想表达的意思,但所用的措辞不正确。
表 7|使用 ACTA 技术开展访谈的研究生的产出质量
效度指标 消防员 (n = 6) 电子战 (n = 5) 认知需求表条目总数中被编码为认知性的比例 92% 94% 认知需求表信息中被认为经验丰富者才可能知道的比例(对各 ACTA 用户取平均) 0.95 (0.05) 0.90 (0.09) 认知需求表信息中与火场指挥员/电子战监督员相关的比例(对各 ACTA 用户取平均) 0.73 (0.10) 0.87 (0.10) 学员手册修改被评为重要或较为重要的比例(对各 ACTA 用户取平均) 0.70 (0.47) 0.93 (0.26) 学习目标被评为重要或较为重要的比例(对各 ACTA 用户取平均) 0.95 (0.43) 0.83 (0.38) 学员手册修改被评为准确的比例(对各 ACTA 用户取平均) 0.89 (0.31) 0.65 (0.48) 学习目标被评为准确的比例(对各 ACTA 用户取平均) 0.92 (0.24) 0.54 (0.50) 注:括号内为标准差。
3.3.3. 信度
目前尚无公认的指标或方法可用于评估认知任务分析工具的信度,然而这个问题十分重要。简言之,问题在于:使用某一特定技术的不同个体能否生成可比的信息,从而使该工具可以被视作一致信息的来源——即在相同(或相似)的领域专家于不同时间点接受访谈、和/或由不同的知识工程师开展访谈的情况下。与高度结构化的访谈格式或量表条目相比,面对文本形式的知识表征时,这一问题要棘手得多。作者尝试从几个方面解决这一问题。途径之一是考察 ACTA 使用者是否一致地引出了相同类型的认知信息。为此,作者检查了学生生成的认知需求的内容,看他们是否生成了相似的信息。
一组分析考察 ACTA 使用者是否生成了相似类型或类别的认知信息。该分析采用了基于 Rasmussen et al.(1994)决策模型的编码方案,对每份认知需求表中的每一条目进行编码。在消防领域,ACTA 组生成的每份认知需求表(100%)都包含与态势分析和计划有关的信息;除一份之外,其余所有认知需求表(80%)都包含信息收集类的数据。鉴于学生被要求聚焦于”火情侦察评估”这一子任务——即收集相关信息,以便准确评估态势并制定行动方案——可以得出结论:本研究中的学生能够使用 ACTA 技术一致地引出相关的认知信息。
同一分析也在电子战研究中进行。所有 ACTA 用户生成的认知需求都包含态势分析类的信息,且除一人之外都收集了信息收集类的数据。信号威胁分析任务的主要内容就是持续收集必要的信息,以便随时保持对态势的准确、当下的评估。数据再次表明,学生能够使用 ACTA 工具一致地引出相关的认知信息。跨两个领域的数据表明,学生能够使用 ACTA 技术一致地引出可比的认知信息。
第二套专门针对消防数据的编码方案同样表明,学生一致地引出了相似的信息。火场指挥员任务被分为三个子任务:火情侦察评估、战术与策略、以及管理。所有 ACTA 用户都在这三个类别中获得了信息。所收集信息的主体聚焦于火情侦察评估任务(62%)——这正是研究者要求学生访谈聚焦的部分。由此可以得出结论:使用 ACTA,人们能够一致地获取覆盖整个火场指挥员任务的重要认知信息,且以火情侦察评估任务为重点。
作者还尝试评估不同 ACTA 用户生成的认知需求表之间具体条目的重合程度。事实证明这极其困难,因为研究者并未在使用者的细节层次、措辞或具体性上加以约束。一名学生可能把”烟的样子”列为认知需求,而另一名学生的表述则是”烟的颜色与流动”。评分者为判断任意两条认知需求表条目是相似还是不同所需的推断程度变得不可接受,该分析因此被放弃。
不过,对认知需求表的非正式检视表明,研究生在多数情况下并未生成完全相同的认知需求。考虑到本研究的设计,这并不奇怪。为降低被试内变异,作者把对将要开展认知任务分析的领域有任何经验的研究生排除在研究之外;这意味着所有学生在开展 CTA 时都处于不利地位。当向专业听众介绍 ACTA 工具时,我们建议在开展访谈之前花时间熟悉领域。而在本研究中,学生只获得了关于领域与任务的简要介绍。我们与研究生相处的有限时间无法实现所建议水平的领域熟悉度。研究生未能生成相同认知需求的另一个原因是,每名学生只接触了两次与领域专家的访谈。如果领域专家的可得性允许每名学生按通常建议接触三到五名专家,学生们在访谈中听到的内容就更可能相似。
3.3.4. 组间差异
本研究设计的一个缺陷是样本量有限。训练被试掌握 ACTA 方法所需的高强度工作坊准备、提供实证评估数据所需的大量编码与数据转换工作、以及可用的领域专家数量有限,都使大样本超出了可获得的时间与资源。显然,在如此小的组别规模下,与 ACTA 组成员身份相关的效应必须非常强才能在统计上被分辨出来。尽管如此,作者仍然惊讶地发现,ACTA 组与非结构化访谈组在数据上的差异如此之少。除样本量小之外,还发现了较大的组内差异,这似乎也是未能得到统计显著结果的原因之一。虽然研究者尝试在年龄、性别和受教育程度上对两组进行匹配,但学生在开展访谈时的自在程度与轻松程度(据研究者观察)存在相当大的个体差异。这导致几乎所有比较指标上都有很大的标准差,使得那些统计显著的结果也难以解释。例如,在评价研究参与体验时,消防与电子战研究中 ACTA 组的研究生对”我对自己主持访谈的能力有信心”这一陈述的认同程度(M = 4.18, SD = 0.60)强于开展非结构化访谈的研究生(M = 3.25, SD = 0.87),U = 28.5, p = 0.02。[由于电子战领域 ACTA 学生的反应不存在方差,故采用不依赖方差假设的 Mann-Whitney U 检验代替 t 检验。]在消防研究中,ACTA 组对”我觉得我已拥有修改课程材料所需的信息”这一陈述的认同程度(M = 4.00, SD = 0.89)强于非结构化组(M = 2.67, SD = 1.03),t(10) = 2.39, p = 0.06。这些统计分析表明,接受 ACTA 训练的学生比非结构化组对开展访谈更有信心,也更确信自己收集了足以修改课程材料的信息。然而,观察这些较大的标准差便可清楚地看到,每组中有些学生很有信心,而另一些学生则不然。
在另一些情形中,均值显示两组差异甚微,但标准差显示组内变异相当可观。例如,对于”就现有信息而言,我觉得修改课程材料是件简单直接的事”这一问题,两组的均值几乎相同;但较大的标准差表明,每组中都有一些人认为修改课程材料简单直接,而另一些人则不然(表 8)。鉴于本研究使用的样本量较小,显然这些组间差异的比较并不十分稳健。
表 8|访谈者问卷问题 10 的均值反应
ACTA 组
消防领域ACTA 组
电子战领域非结构化组
消防领域非结构化组
电子战领域就现有信息而言,我觉得修改课程材料是件简单直接的事 3.67 (0.82) 3.83 (1.47) 3.00 (1.23) 3.33 (1.03) 注:反应采用 5 点评定量表,1 = 非常不同意,5 = 非常同意。括号内为标准差。
本研究设计中一个潜在的混淆因素是:在导入工作坊期间,非结构化组在开展访谈之前也听了关于认知要素、认知任务分析以及如何填写认知需求表的授课。对原始数据的检视表明,非结构化组中的一些学生可能利用认知需求表来组织其访谈,从而缩小了 ACTA 组与非结构化组之间的差距。这对 ACTA 的启示是:认知需求表是一种有价值的工具,可用于框定访谈者打算从领域专家那里引出的信息类型。
虽然作者曾考虑设置一个不接受任何认知导入工作坊的对照组,但考虑到研究既要比较访谈中引出认知信息的数量、又要比较所产出训练材料的质量,这样做并不现实。为了进行这些比较,必须向所有参与者提供关于如何创建认知需求表以及如何产出教学材料的培训。两个访谈组都获得了较高的质量评定(即领域专家的重要性与准确性评定),这一事实表明:接触认知任务分析的基本概念、了解认知任务分析数据如何应用于教学材料,可能在学会开展认知任务分析的过程中发挥着重要作用。仅仅依靠这些基础性材料、而未接触具体方法,非结构化组中的一些学生也能够收集到准确、相关的认知信息,并开发出有用的教学材料。
4. 讨论
本文呈现的结果表明,经过一个介绍 ACTA 技术的 6 小时工作坊,研究生便能够与领域专家开展访谈,并引出重要的、准确的、可轻松转化为教学材料的认知信息。此外,主观可用性数据表明,研究生认为这些技术易于使用、灵活,并能提供清晰的产出。作者相信,专业的教学设计者和系统设计者会比研究生做得更好,因为他们使用认知信息的目标更为具体,而且拥有更多开发应用产品的经验。
虽然本文尝试确立 ACTA 方法的信度与效度,但作者清楚,目前尚无公认的成熟指标。必须在真实世界场景中用真实任务检验 CTA 方法,这一现实需要大大削弱了研究者对诸多变异来源的控制。难以控制的因素包括:有些人似乎天生比其他人更擅长访谈;此外,有些领域专家更善于表达、更容易聚焦。鉴于访谈者与领域专家这两个角色内部都存在的人际差异,回答以下问题将十分重要:同一位领域专家在稍后的时间被问及相同的问题时,是否会报告相同的例子与细节?不同的访谈者使用 CTA 技术时,是否会引出相同类型的信息?独立的实践者基于 CTA 访谈是否会生成相同的材料?我们还需要进一步的工作来建立有意义的指标,以评估 CTA 工具的信度与效度。
这里必须指出的一点是:尽管 ACTA 方法已被证明能引出重要且准确的认知信息,但作者尚未尝试评估使用这些精简化的技术会损失什么。我们认为存在一种权衡:CTA 技术越是精简化、程序化,其效力就越弱。与更系统化的技术(如 PARI 方法(Hall et al. 1994)以及 Gordon and Gill(1992)的概念图分析)相比,ACTA 技术收集的信息似乎不那么全面;与关键决策法(Klein et al. 1989)或 Rasmussen(1986)的认知分析相比,其收集的信息也更为表层。尽管精简化的 CTA 流程存在这些局限,ACTA 技术仍为研究生提供了足够的工具,使他们得以识别关键认知要素并开发出有用的训练材料。然而,在更好的指标出现之前,将难以客观评估不同方法各自的得失。
同样重要的是要指出:在需要高水平认知技能的复杂任务中,若不去研究并纳入认知议题,会有什么后果。尽管自动化与智能系统前景可期,但在存在不确定性与模糊性的系统中,人类决策者始终会扮演一定角色。不训练操作员习得所需的认知技能,或不设计支持人类问题解决与决策的系统,其后果可能是灾难性的——三里岛(Three Mile Island)、美国海军”文森斯”号巡洋舰(USS Vincennes)、国王十字车站(Kings Cross Station)等灾难便是例证(Reason 1990)。
ACTA 方法论最初以工作坊形式传授,这使工作坊讲授者得以针对听众调整方法,并在授课中加入个人轶事。这也意味着没有两个 ACTA 工作坊是完全相同的,从而使方法信度的研究更加难以开展。不过,近来 ACTA 工作坊已被制成基于光盘的多媒体训练工具(Militello et al. 1997)。该工具为学习者提供开展认知任务分析的理由、认知与专长的入门介绍,以及三种 ACTA 方法的教程。它为开展更严格受控的 ACTA 方法论有效性与信度比较提供了机会。未来的研究议题包括:考察知识引出与知识表征的信度与效度,以及最终产出的训练与系统干预的信度与效度。
未来使用 ACTA 的研究还应探索以下领域:纳入可用于分析那些隐含地依赖多操作员交互与团队合作的任务的方法;改进 ACTA 与更传统、更系统的任务分析技术的结合;改进知识表征,使其能更方便地转化为训练与系统设计干预;以及改进训练方法与系统、界面设计干预本身,使认知优势与认知弱点都能得到更好的支持。
致谢
本研究根据合同编号 N66001-94-C-7034,由美国海军人事研究与发展中心(Navy Personnel Research and Development Center,San Diego, CA, USA)资助完成。
(参考文献共 48 条,此处从略。)
译注: 1. 原文为扫描版 PDF,OCR 文本错乱较多。标题、作者、摘要、正文各章节、图 1—3、表 1—8、各脚注及全部统计数值均已对照原书页面放大图像逐页核对后翻译;正文中的访谈提问等例句原文以斜体排印,中译以斜体表示。 2. 图 1 为手绘任务图,第一个步骤框 OCR 误识为 “Initial response”,据原图更正为 “Initial Assessment”(初始评估)。 3. 表 2”关键线索”栏中 “Cold –> 15°” 原图即如此书写(疑指气温华氏 15 度左右),中译照录为”寒冷(15°)“。 4. 引言中 Roth et al. (1991) 的年份按原文照录;文末参考文献表中 Roth, Woods 与 Popp 一条署为 1992 年,原文即如此,未作改动。 5. 第 2.3 节首段”Klein (1993)” 的年份,OCR 误为 1995,据原图核对更正为 1993。 6. 作者单位邮编 OCR 误为 43524,据原书首页核对更正为 45424。 7. 第 3.3.4 节 Mann-Whitney 检验统计量 OCR 误为 18.5,据原图核对为 U = 28.5, p = 0.02。 8. 3.3.1.1 节方差分析原文为 “3-way, mixed design ANOVA”(3 因素混合设计方差分析),OCR 误作 “1-way”,已据原图更正。 9. 表 4、表 5、表 6 中的均值与标准差均逐格对照原图转录;表 4 首行(熟悉工具所用时间)采用 3 点量表(脚注 †),故无”ACTA 总体”数据(原文标注 NA)。 10. 参考文献列表(References,共 48 条)按翻译要求未译出。